텍스트 익명화, '이름 지우기'로 끝나지 않는다 — TAB 벤치마크 논문 해설
한 문장 요약: 이 글을 읽으면 익명화(anonymization)와 비식별화(de-identification)의 결정적 차이, 그리고 그 차이를 정량으로 측정하기 위해 고안된 TAB 벤치마크의 설계 논리를 이해할 수 있습니다.
개요
- 주제: Computational Linguistics Volume 48, Number 4에 게재된 TAB(Text Anonymization Benchmark) 논문 해설
- 핵심 관점: "고정된 카테고리 지우기"로는 개인정보 보호를 측정할 수 없다는 저자의 문제의식
- 핵심 키워드: 익명화, 비식별화, 준식별자, ECHR 판결문, 마스킹 결정, 프라이버시 지표
핵심 메시지 3가지
1. 익명화는 비식별화와 다른 작업이다 저자는 GDPR 정의를 근거로, 익명화란 "개인을 확실하게 재식별시킬 수 있는 정보를 직접·간접으로 완전하고 비가역적으로 제거하는 것"이라고 규정한다. 반면 NLP에서 흔한 시퀀스 레이블링 기반 접근은 이름·전화번호·주소 같은 정해진 의미 범주만 제거하므로, 외모·직업·정치적 견해 같은 덜 눈에 띄는 요소를 놓친다. 저자는 이런 수준을 "de-identification이며 anonymization은 아니다"라고 명확히 구분한다 [원문 p.1054~1055].
2. 마스킹 여부는 '카테고리'가 아니라 '판단'이다 TAB의 결정적 차이는 어노테이션 자체를 실제 익명화 작업처럼 수행했다는 점이다. 각 텍스트 스팬에 어노테이터가 "이 스팬을 마스킹해야 하는가"라는 마스킹 결정(masking decision)을 부여한다. 저자는 이것이 인간 전문가의 문서 색인 실무를 반영한다고 주장한다 [원문 p.1055].
"각 주석 달린 텍스트 스팬에는, 해당 스팬을 마스킹해야 한다는 어노테이터의 판단을 표현하는 마스킹 결정이 연결된다"
3. 기존 지표는 프라이버시를 과대평가할 수 있다 저자에 따르면 기존 IR 지표(precision/recall/F₁)는 개현(occurrence) 단위라서, 같은 사람의 식별자가 문서 여러 곳에 등장할 때 "하나만 안 지워도 되는" 착시를 만든다. 또한 전체 이름 공개와 국적 공개를 동등 취급한다는 한계가 있다.
1. 왜 이 논문이 필요한가 — 비식별화의 두 가지 실패
| 구분 | de-identification(비식별화) | anonymization(익명화) |
|---|---|---|
| 대상 | 정해진 의미 범주(이름, 전화번호, 주소) | 재식별에 기여할 수 있는 모든 텍스트 요소 |
| 기준 | 범주 목록(HIPAA 18종 등) | 배경지식을 가진 공격자 관점의 노출 위험 |
| 한계 | 과소 마스킹 + 과다 마스킹 동시 발생 | GDPR상 "성공한" 익명화만 개인정보 규제 밖 |
저자는 HIPAA의 18종 목록을 예로 들며, "이러한 유형들은 결코 준식별자의 완전한 목록이 아니므로 HIPAA 기반 보호는 익명화가 아니라 비식별화로 분류되어야 한다"고 비판한다 [원문 p.1058]. 동시에 비식별화는 위험과 무관한 날짜·장소 범주까지 일괄 마스킹하므로 오히려 정보를 과도하게 파괴한다고 지적한다.
준식별자의 결합 위험도 수치로 제시된다 — 저자가 인용한 Golle(2006) 연구에 따르면 성별 + 생년월일 + 우편번호 조합만으로 미국 인구의 63%~87%를 확실히 식별할 수 있다 [원문 p.1057].
2. TAB 코퍼스는 어떻게 구성됐나
저자들은 세 가지 기준으로 문서 모집단을 골랐다: ① 반구조화·단문이 아닌 풍부한 순수 텍스트, ② 사전 정의 범주에 갇히지 않는 실제 개인의 광범위한 개인정보, ③ 사전 (가)익명화되지 않은 자유 재배포 가능한 공개 출처이면서 유명인에 편중되지 않을 것.
| 항목 | 내용 |
|---|---|
| 출처 | 유럽인권재판소(ECHR) 판결문 |
| 규모 | 1,268건 영어 사건 |
| 어노테이션 층 | 의미 범주, 식별자 유형, 기밀 속성, 공 지칭 관계 |
| 핵심 결정값 | 스팬별 마스킹 결정(mask or not) |
| 공개 위치 | github.com/NorskRegnesentral/text-anonymization-benchmark |
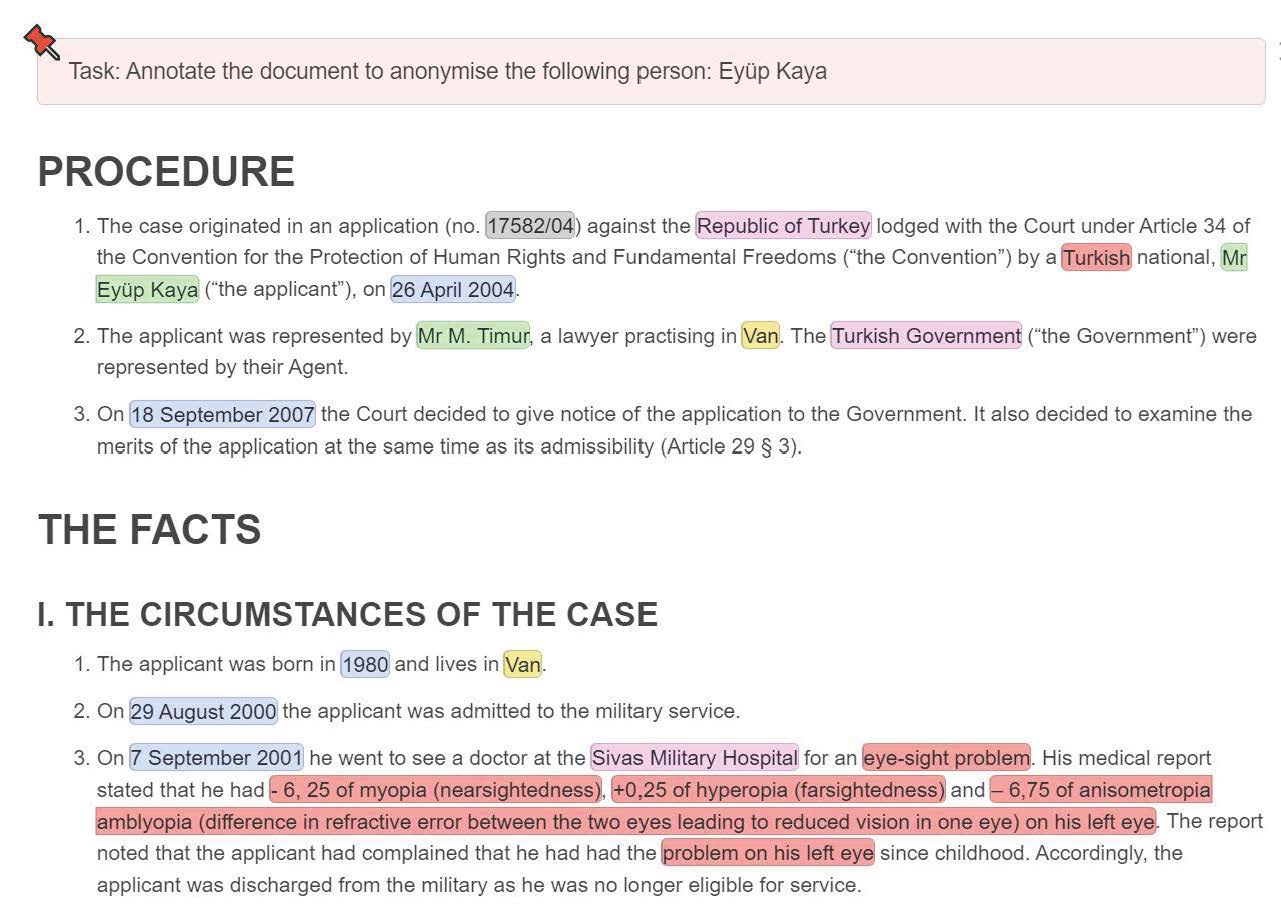
의료 기록과 달리 판결문은 원고·증인·제3자 복수 개인을 동시에 다루고, 인과 관계가 얽힌 전기적 서술을 포함한다 — 그래서 일반 목적 익명화 벤치마크로 적합하다는 것이 저자의 논리다. 반면 기존 의료 데이터셋(2014 i2b2/UTHealth: 1,304건·296명 환자, 2016 CEGS N-GRID: 정신과 초진 기록 1,000건)은 문서마다 환자 한 명만 서술해 과제가 단순화된다는 점을 저자는 지적한다 [원문 p.1063].
3. 어노테이션 절차 — 성립 조건과 저자의 실제 설정
TAB의 어노테이션은 4단계로 구성되며, 각 단계는 서로 다른 판단을 요구한다.
① 엔티티 식별 (NER 사전주석 + 수동 보정) → ② 식별자 유형·기밀 속성 부여 (전면 수동) → ③ 마스킹 결정 → ④ 공 지칭 관계 표시
여기서 확인해야 할 성립 조건과 예외가 있다.
- 사전주석(pre-annotation)의 역할과 한계: 1단계는 데이터 기반 NER 모델 + 도메인 휴리스틱으로 초기화됐지만, 어노테이터가 전체 엔티티 멘션의 18.23%(어노테이터별 ±3.25%)를 직접 삽입했고, 삽입·편집을 합치면 23.89%(±5.14%)에 달한다. 즉 사전주석은 보조일 뿐 완전하지 않다 [원문 §5.3].
- 기밀 속성·식별자 유형은 예외적으로 사전주석 범위 밖: 이 두 레이블은 사전주석에 포함되지 않아 모든 엔티티에 대해 전면 수동으로 수행됐다 [원문 §5.3].
- 공 지칭 관계의 성립 조건: 표면 표현(surface realization)이 달라도 같은 실체를 가리킬 때만 표시한다(예: "Government of the Republic of Turkey" – "Turkish Government"). 총 5,689개 관계가 식별되었으며 전체 엔티티의 3.7%다. 관계 쌍에 대한 Cohen's κ는 0.944 [원문 §5.4].
- 경계 결정의 예외적 사례: 스팬 경계는 사전주석 덕분에 대체로 일관됐으나, 170개 스팬이 100자를 초과하는 비정상적 길이를 보였고 대부분 약어화·번역된 엔티티 이름에서 비롯됐다 [원문 §5.2].
4. 평가 지표 — 개현이 아니라 '엔티티'로 측정한다는 성립 조건
저자가 제안한 프라이버시 지표가 작동하려면 두 가지 전제가 성립해야 한다.
- 엔티티 단위 평가: 개인 식별자는 문서 내 모든 출현이 마스킹되어야만 은폐된다 — 하나라도 남으면 식별자 전체가 노출된다는 가정.
- 식별자 가중: 직접 식별자(전체 이름) 공개가 간접 정보(국적·성별) 공개보다 더 심각한 위협이라는 가중 구조.
유틸리티 지표는 마스킹된 어휘가 담고 있던 정보량 손실을 측정하는 방식으로 정의된다. 저자는 이러한 지표가 표준 IR 지표보다 프라이버시 보호 수준과 유틸리티 보존을 "더 정확하게" 평가한다고 주장한다 [원문 p.1055]. 다만 이는 설계 의도이며, 지표 자체의 타당성에 대한 외부 검증은 논문 본문 범위 밖이라는 점을 유의해야 한다.
5. 베이스라인 실험 — 저자가 실제 사용한 설정
저자들은 세 유형의 접근법에 대해 베이스라인 결과를 제시한다.
- NER용으로 학습된 일반 신경 모델
- 프라이버시 지향 NER 기반 비식별화 시스템
- TAB 판결문으로 파인튜닝한 BERT 기반 시퀀스 레이블링 모델
결과에 대해 저자는 "텍스트 익명화 과제의 난이도와, 신원 공개 방지에 있어 전통적 NER 지향 비식별화 방법의 한계"를 시연한다고 주장한다 [원문 p.1056]. 데이터 프로파일에서도 평가 지표 시트에 Rdi+qi 값(예: 0.531, 0.795, 0.622, 0.643, 0.583, 0.507)과 QUASI vs. NO_MASK 비교 열이 확인되어, 준식별자 포함/제외 조건별 성능 대비가 실험 설계에 포함됐음을 보여준다.
6. 선행 연구와의 균형 — TAB이 세운 자리
| 연구 계열 | 기여 | TAB이 지적한 한계 |
|---|---|---|
| 의료 NLP (i2b2 2014, CEGS N-GRID 2016) | PHI 표준화·공유과제로 도메인 발전 견인 (i2b2 상호일치 F₁ 0.89/0.93, 최신 SOTA 0.98+) | 문서당 환자 1인, HIPAA 범주 고정 → 비식별화 수준 |
| PPDP 계열 (Sánchez·Batet의 C-sanitize 등) | 노출위험을 명시적으로 모델링, 모든 어휘를 대상으로 식별 | 문서를 어휘 집합으로 축소해 문맥 무시, 확장성 한계 (Lison et al. 2021) |
| 위키피디아 전기 평가 (Chow et al. 2008 등) | 공개·비편향 데이터로 분포 기반 위험평가 가능 | ① 텍스트가 웹에 대량 복제되어 위험을 과대 인상시킴 ② '저명인' 편중으로 일반인 평가 불균형 ③ 스팬 주석이 이진(민감/비민감)뿐 |
| Enron 이메일·SMS 등 | 대규모 공개 데이터 | 이미 (가)익명화되어 가장 노출 위험한 정보가 사전 제거 → 평가 왜곡 |
저자는 위키피디아 전기 계열의 공헌(민감/비민감 이진 주석이 NER 주석보다 노출위험 포착에 더 정확하다는 Lison et al. 2021의 결과)을 인정하면서도, 주석이 이진이라 엔티티 유형·위험 유형(신원 공개 vs 속성 공개)을 구분하지 못한다는 점을 균형 있게 지적한다 [원문 p.1062~1063]. 후속 연구 방향으로는 저자가 결론에서 밝힌 대로, TAB 이외 도메인으로의 일반화와 익명화·유틸리티 트레이드오프의 더 정교한 모델링이 남아 있다.
관점 포인트
- 범주 목록이 곧 보호 수준이 아니다 — HIPAA 18종을 지켜도 GDPR 기준 익명화는 아닐 수 있다
- 마스킹 결정은 어노테이터의 판단이다 — κ 같은 합의 지표가 낮은 레이블(특히 마스킹 결정 그룹)은 해석에 주의가 필요하다
- 사전주석 파이프라인은 18~24%를 사람이 고친다 — 자동 파이프라인 성능이 곧 어노테이션 품질이라고 가정하면 안 된다
- 지표 선택이 결론을 바꾼다 — 개현 단위 F₁과 엔티티 단위 프라이버시 지표는 같은 시스템에 다른 순위를 매길 수 있다
- 평가 데이터의 이력이 성능에 개입한다 — 이미 (가)익명화된 코퍼스는 쉬운 문제만 남긴다
최종 핵심 정리
확인해야 할 핵심 질문:
- 우리가 지우는 것은 '범주'인가 '재식별 위험'인가?
- 같은 식별자의 모든 출현이 지워졌는가, 일부만 지워졌는가?
- 준식별자 조합(성별·생년·지역)까지 고려했는가?
- 마스킹 후 원문의 사실 진실성은 유지되는가? — 저자가 강조한 대로 의료 기록의 "bronchitis"를 임의의 병명으로 바꾸면 연구에 쓸모없어지듯, 판결문의 판시 내용도 왜곡되면 안 된다 [원문 p.1060]
- 평가 코퍼스 자체가 사전 (가)익명화되지 않았는가?
한 줄 요약: 익명화는 "정해진 이름을 지우는 기술"이 아니라 "배경지식을 가진 공격자 앞에서 재식별 위험을 낮추면서 문서의 진실성은 지키는 판단"이며, TAB은 그 판단을 엔티티 단위로 측정할 수 있는 최초의 공개 코퍼스를 제시했다.
댓글 0
아직 댓글이 없습니다 — 첫 댓글을 남겨보세요.