ScientistTwo 논문 리뷰: AI가 스스로 논문을 쓰고 SOTA를 넘어서는 방법
[미디어: https://arxiv.org/abs/2609.19644]
한 문장 요약: 이 글을 읽으면 Google Cloud AI Research가 발표한 자율 연구 에이전트 ScientistTwo의 파이프라인 구조, 성립 조건, 실험 결과, 그리고 저자가 주장하는 것과 실측된 것의 경계를 이해할 수 있습니다.
개요
- 주제: 문제 주도(problem-driven) 자율 과학 발견을 위한 다중 에이전트 프레임워크 ScientistTwo 해설
- 핵심 관점: "저자의 해석"과 "검증된 실험 결과"를 분리해 보고, 핵심 기술 관계는 성립 조건과 저자가 실제 사용한 설정까지 확인
- 핵심 키워드: ScientistTwo, 자율 연구 에이전트, 어블레이션, 동료 심사 시뮬레이션, 무결성 감사
논문 정보: ScientistTwo: Pioneering the Human Knowledge Frontier with Autonomous AI, Jaehyun Nam 외 (Google Cloud AI Research / University of Waterloo), 문서 표기일 2026-09-18 (원문 표지).
핵심 메시지 3가지
1. "보조 도구"가 아니라 "자율 연구 주체"라는 주장
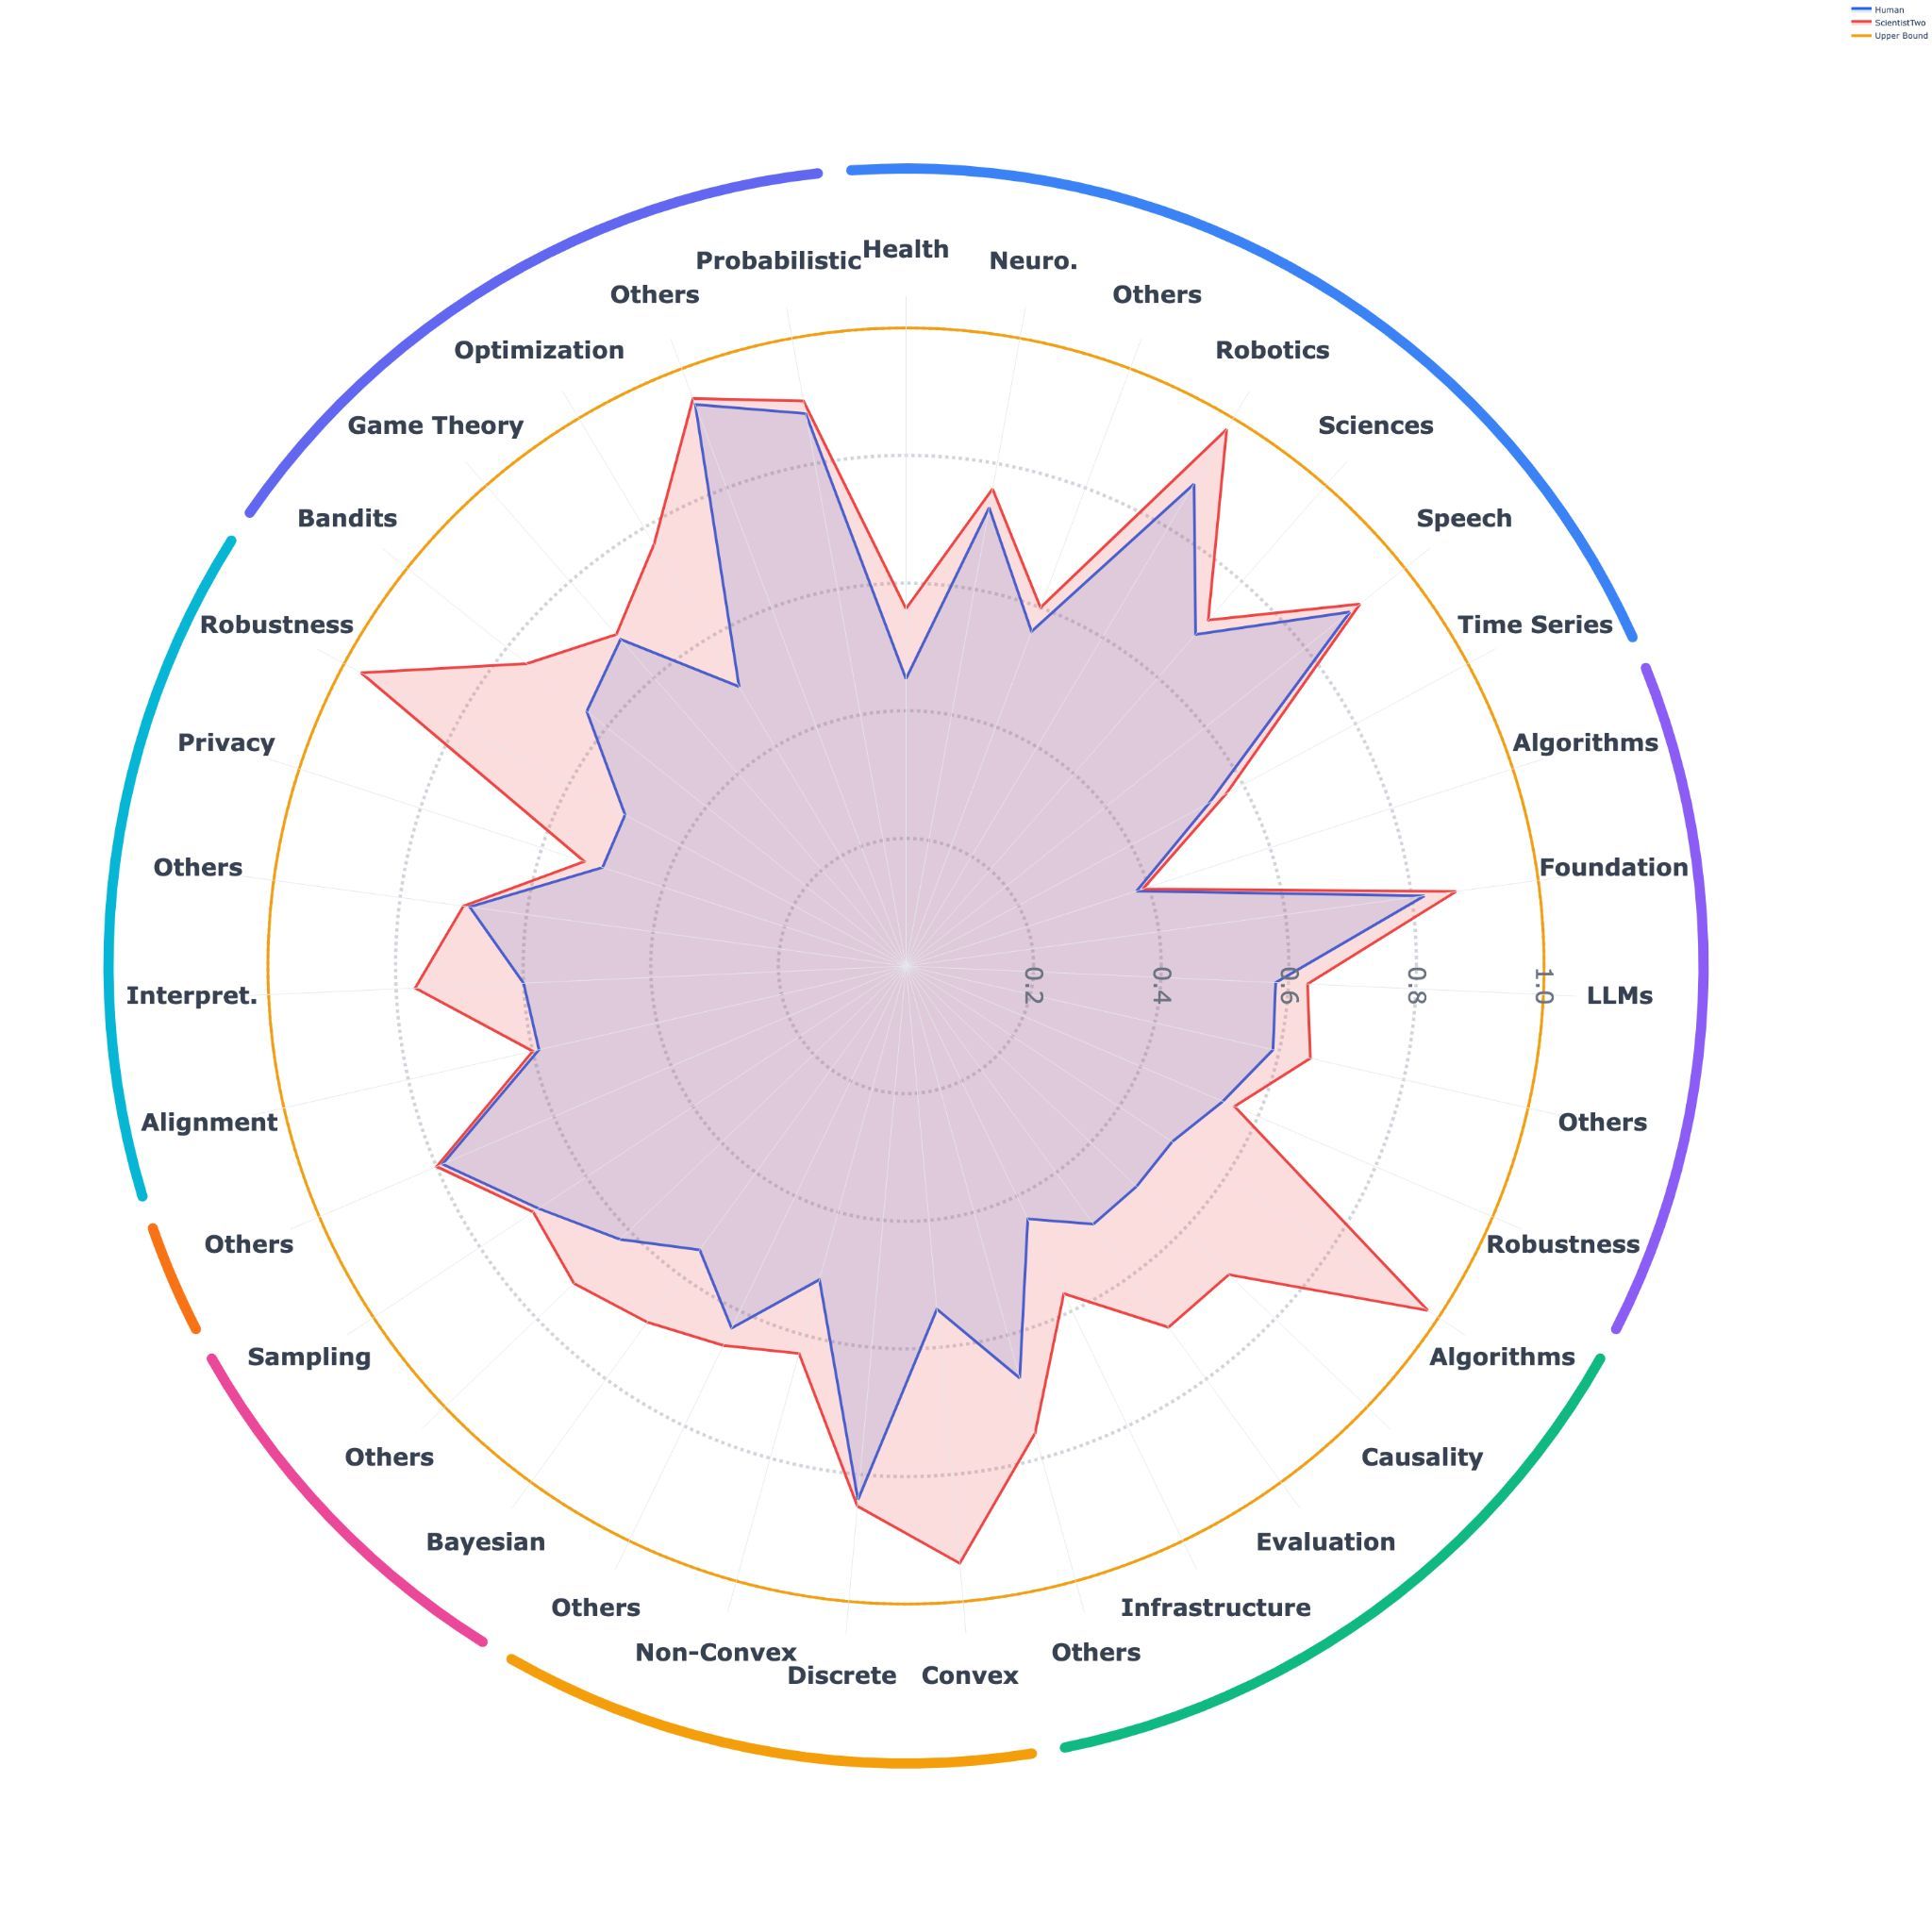
저자는 ScientistTwo를 단순 보조 도구가 아니라 "인류의 발견을 전진시킬 수 있는 자율적 과학 개척자(an autonomous scientific pioneer)"로 규정합니다. 이는 저자의 해석·주장에 해당하며, 이를 뒷받침하는 실측 근거는 1천분의 5 성공률로 확인됩니다.4%)에서 인간 SOTA를 개선, 평균 상대 개선 25.2%** 라는 수치입니다 (원문 Figure 1).
2. 핵심은 "실험 → 비평 → 수정" 루프의 반복
모든 파이프라인 단계가 stage → critic → refine 구조로 추상화됩니다. 비평 에이전트가 "accept"를 반환하면 산출물이 통과되고, "refine"이면 피드백 기반으로 수정하며, 그 외에는 폐기됩니다 — 최대 반복 횟수 max_rounds가 상한입니다 (원문 Listing 1, Table 1).
3. 결과는 수치로 검증 가능해야 한다
저자는 생성된 논문과 코드베이스가 무결성 차원(점수 재현·명세 준수·참고문헌·방법-코드 정합)에서 검증 가능해야 한다고 강조하며, 재현 49/49, 명세 위반 0/49, 환각 인용 0/1814, 방법-코드 정합 49/49 를 보고합니다 (원문 Table 7).
1. ScientistTwo란 무엇인가
문제 주도 자율 발견을 수식으로 정의하면 이렇습니다. 주어진 과학 문제 𝒢에 대해 에이전트 집합 𝒜가 논문 ℘⁺와 재현 가능한 코드베이스 𝒞⁺를 생성합니다:
(℘⁺, 𝒞⁺) = 𝒜(𝒢), where 𝒜 = {𝒜₁, 𝒜₂, …, 𝒜_{Nₐ}} (식 1)
여기서 성립 조건이 중요합니다. 논문이 통과하려면:
- ℘⁺는 𝒢의 핵심 방법론적·경험적 병목을 식별하고 해결해야 하고
- 𝒞⁺는 제안 아이디어를 정확히 구현하면서 실행 재현성과 측정 가능한 성능 이득을 입증해야 합니다 (원문 §3)
에이전트 𝒜는 Nₐ개의 전문 에이전트로 구성되며, 각각 한계 추출·아이디어 생성·코드 수정·실증 검증 등 연구 수명주기의 서로 다른 단계를 담당합니다.
2. 파이프라인: 6단계 흐름
① 한계 식별 & 시드 아이디어 생성 (§3.1) → Limitation Extractor가 한계를 추출하고 Limitation Verifier가 "충분한가"를 검증, 불충분하면 재추출 (최대 반복 횟수 도달 시 중단) → Novelty Checker로 신규성 점수를 매긴 뒤 N_seed개 시드 아이디어를 신규성 내림차순 정렬
↓
② 아이디어 평가: 부분집합 → 전체집합 (§3.2) → Baseline Coding Agent가 부분집합에서 기준선 재현 → 상위 N₀개 아이디어를 부분집합에서 구현·평가
↓
③ 아이디어 개선 (§3.3) → 과거 실행 트레이스 R_<k를 분석해 진화 아이디어 생성, 미평가 시드 아이디어와 결합(탐색·활용 균형)
↓
④ 어블레이션 연구 (§3.4) → Ablation Planner가 N_p개 계획 수립, 컴포넌트 기여도 분리 → 불필요 컴포넌트 제거로 아이디어 재정제
↓
⑤ 초안 작성 & 동료 심사 (§3.5) → Review Agent 비평, Rebuttal Agent가 보완 실험을 직접 설계·실행
↓
⑥ 메타 리뷰 (§3.6) → Meta-Review Agent가 채점 기준 충족 여부 판정, 미충족 시 아이디어·어블레이션 분석까지 되돌아가 반복
3. 핵심 기술 관계: 성립 조건과 저자가 실제 사용한 설정
판정 3분기와 부분집합→전체집합 확장
아이디어 평가의 판정은 세 갈래입니다. 성립 조건과 예외를 반드시 함께 봐야 합니다.
| 판정 | 조건 | 후속 조치 |
|---|---|---|
| Bad | 성능이 기준선보다 실질적으로 열위 | 아이디어 폐기 |
| Good | 기준선을 일관되게 능가 | 전체 벤치마크로 확대 |
| Engineer | 잠재력은 있으나 하이퍼파라미터·코드 조정 필요 | Subset Engineering Agent가 전략 r^h에 따라 수정 |
중요한 예외 조건: 이 수정 루프는 d^h ∈ {Good, Bad}가 나올 때까지 반복되지만, N_eng 반복 예산이 소진되면 Good을 달성하지 못한 아이디어는 Bad로 지정되어 가지치기됩니다. 저자는 이를 "실제 연구에서 무망한 경로를 제한적 최적화 후 포기하는 상황을 반영"한 것이라고 설명합니다 (원문 §3.2).
탐색·활용 균형의 결합 조건
아이디어 진화만 의존하면 초기 시드 아이디어 주변의 지역 최적점에 갇힐 위험이 있습니다. 그래서 후보 풀은 결합 조건으로 구성됩니다:
H_k = I_k ∪ H_0^(k) — 진화 아이디어 집합 I_k에, 신규성 점수 내림차순으로 아직 평가되지 않은 시드 아이디어 N_e개(H_0^(k))를 결합 (원문 §3.3)
종료 조건 (전제·한도)
- 성공 아이디어 d^h = Good이 S개 누적되면 성공 종료
- 최대 정제 한도 K에 도달하면 종료
- round K까지 성공 아이디어가 0개면 전체 프로세스를 중단합니다
즉 "무한히 돌려서 좋은 결과를 고르는" 구조가 아니라, 예산(N_eng, K, S)이 명시된 유한 탐색이라는 점이 성립의 전제입니다.
저자가 실제 사용한 주요 설정
- 주 실험의 코딩 에이전트는 Claude Code (Opus 4.8) — 일반형은 여러 백본을 허용하지만 주 설정은 이것입니다
- 일반화성 검증에서는 Antigravity (Gemini 3.8 Flash)로 교체, ICLR 2026 채택 논문 출처 5개 태스크에서 시험 (원문 Table 8)
- 어블레이션·리뷰 루프의 최대 반복은
max_rounds로 상한이 걸려 있습니다
4. 실험 결과: 무엇이 검증됐고 무엇이 아닌가
벤치마크 성과 (실측)
| 지표 | 값 | 출처 |
|---|---|---|
| 평가 과제 수 | 107개 (ICLR·ICML·NeurIPS 등) | 원문 Figure 1 |
| 성공 과제 | 86/107 (80.4%) | 원문 Figure 1 |
| 평균 상대 개선 | 25.2% | 원문 Figure 1 |
동료 심사 시뮬레이션 효과 (표 5, 1–10점 척도)
| 프레임워크 | 라운드 | Rebuttal | ScholarPeer 평균/채점률 | Stanford Agentic Reviewer 평균/채점률 |
|---|---|---|---|---|
| ScientistOne | - | - | 3.8±1.2 / 14.3 | 4.1±0.7 / 0.0 |
| ScientistTwo (Variant) | 0 | ✗ | 5.2±2.2 / 46.9 | 5.6±0.5 / 49.0 |
| ScientistTwo (Ours) | 1 | ✓ | 6.9±1.6 / 79.6 | 5.8±0.6 / 73.5 |
| ScientistTwo (Ours) | 2 | ✓ | 7.6±1.0 / 93.9 | 5.7±0.6 / 69.4 |
해석에 주의가 필요합니다. 저자는 "Rebuttal Agent가 ScholarPeer의 약점을 효과적으로 해소한다"고 평가하면서도, ScholarPeer 리뷰를 학습에 쓰기 때문에 ScholarPeer 점수가 오르는 것은 기대된 바이며 진짜 관찰은 "이 프레임워크가 Review Agent 전반에 일반화된다"는 것 — Stanford Agentic Reviewer 채점률도 개선된다는 점을 논거로 듭니다. 또한 Variant(Rebuttal 없음) 행에서 이미 ScientistOne을 크게 앞선다는 점을 들어, 앞선 자율 연구 사이클 자체가 초안 품질에 기여한다고 주장합니다.
사례 연구: 리뷰 주도 개선 (표 6, TOFU forget10, Llama-3.2-1B-Instruct)
- 인간 기준선 Engram (Kwon et al., 2026): Overall 0.705
- ScientistTwo 1차 산출 LFR-Engram: 0.897 — 이미 SOTA 달성
- 메타 리뷰가 "전문가 기준 미달"로 판정 → 피드백 반영 후 FCD-Engram: 0.916
저자는 이 사례를 "리뷰 주도 개선이 더 새로운 아이디어에 필수적"이라는 근거로 제시합니다.
반복적 프론티어 확장 (표 9)
| 순서 | 방법 | 상대 개선 |
|---|---|---|
| 인간 기준 | Jiang and Gong (2026) | - |
| 1차 | VD-STrans | 10.9% (Rating 6.5) |
| 2차 | BXT-Transducer | 9.6% (Rating 5.6) |
| 3차 | SBR-Transducer | 8.2% (Rating 7.1) |
이득이 10.9% → 9.6% → 8.2% 로 감소 추세임을 그대로 보고합니다 — "복리식 발견"이 가능하다는 주장의 근거인 동시에, 이득이 줄어든다는 제약도 데이터에 드러납니다.
비용 (원문 §4.3, Figure 10)
- NeurIPS 2025 출처 문제 기준, 전체 연구 사이클 완료에 평균 2–3일 (Figure 10(a) 캡션은 "단일 논문 개선에 평균 2.5 days"로 표기)
- 평균 비용 $3765 (토큰 사용료 + 가상머신 비용)
- 시간 대부분은 Idea Refinement·Dynamic Peer-Review·Meta-Review 단계에 집중
5. 선행 연구와의 관계, 그리고 균형점
선행 연구 인정
저자는 기존 자율 연구 에이전트들이 "단일 스칼라 지표 최적화"에 머물러 있고 "인간 과학자의 폐루프 실증 엄밀성"이 부족하다고 비판합니다 (원문 §1). 관련 연구로 ReAct·AutoGen·Voyager·SWE-agent 등 일반 에이전트, MLAgentBench·AIDE·MLE-STAR·MARS 등 ML 엔지니어링 프레임워크를 배치합니다. 특히 MLE-STAR(Nam et al., 2026a) 는 저자 중 한 명의 선행 작업입니다 — 선행·후속 연구의 기여를 구분해 읽어야 하는 지점입니다.
선행 기준선 ScientistOne
성능 비교의 기준이 되는 ScientistOne은 이 논문이 새롭게 만든 것이 아니라, 리뷰에서 "prior state-of-the-art baseline"으로 명시된 기존 시스템입니다. ScientistTwo의 개선은 그에 대한 상대 평가로 측정됐습니다.
인간 평가의 양면성 (표 10)
33개 논문, 9명의 경험 있는 인간 리뷰어, 1–5 Likert 척도:
| 평가 항목 | 독립 점수 | 인간 대비 상대 점수 |
|---|---|---|
| Introduction (동기·관련연구) | 4.2 | 3.1 (Human < ScientistTwo) |
| Method (건전성·알고리즘 엄밀성) | 4.1 | 2.9 (Human > ScientistTwo) |
| Experiment (기준선·벤치마크) | 4.0 | 3.5 (Human < ScientistTwo) |
| Experiment (어블레이션) | 4.3 | 3.3 (Human < ScientistTwo) |
| Overall (과학적 성숙도·투톱 준비도) | 3.7 | 3.0 (Human = ScientistTwo) |
Method 항목 상대 점수 2.9는 3.0(Parity) 미만 — 즉 인간 논문이 앞서는 유일한 항목이며, Overall은 동률입니다. 독립 점수는 전 항목 3.0(긍정 판정 기준)을 넘지만, "인간을 능가한다"는 문장은 이 표의 모든 셀을 지지하지는 않습니다.
저자가 스스로 밝힌 한계
- 비용: 평균 $3765, 2–3일 — 인간 연구자보다 빠르지만 컴퓨팅 예산이 상당
- 이득 감소 추세: 반복 확장 시 상대 개선이 10.9% → 9.6% → 8.2% 로 축소
- 코딩 에이전트 의존: Antigravity 교체 시 성공률 80.0% → 60.0% 로 하락 (평균 이득은 3.8 → 16.7로 반대 방향) — 백본 교체가 성능 분포를 바꾼다는 신호입니다 (원문 Table 8)
관점 포인트
- 성립 조건을 항상 함께 보자: "accept/refine/거부" 루프는
max_rounds,N_eng,K,S라는 유한 예산 위에서만 작동합니다 - 주 설정과 일반형을 구분하자: 주 실험은 Claude Code(Opus 4.8), 일반화성 검증만 Antigravity(Gemini 3.8 Flash)입니다
- 귀속을 구분하자: "자율적 과학 개척자"는 저자의 규정이고, "86/107·25.2%"는 실측입니다
- 채점 에이전트의 중립성에 유의하자: ScholarPeer는 학습 루프에 참여한 채점자라는 점을 저자 스스로 언급합니다
- 인간 평가의 예외 항목을 놓치지 말자: Method 상대 점수 2.9(Human > ScientistTwo)
- 비용·이득 감소曲线를 함께 읽자: $3765, 2–3일, 반복마다 줄어드는 상대 개선
최종 핵심 정리
확인해야 할 핵심 질문:
- ScientistTwo의 성공 판정 기준은 무엇인가? → 86/107, 성공률 80.4%, 평균 상대 개선 25.2%
- 루프가 무한히 도는가? → 아니오. N_eng·K·S 예산이 상한
- 리뷰 시뮬레이션의 효과는? → 표 5: 채점률 46.9 → 79.6 → 93.9 (ScholarPeer)
- 코드 신뢰성은? → 표 7: 재현 49/49, 명세 위반 0/49, 환각 인용 0/1814
- 인간과의 격차는? → 표 10: Overall 3.0 동률, Method 2.9로 인간 우위
- 비용은? → 평균 $3765, 2–3일
한 줄 요약: ScientistTwo는 "비평 에이전트가 붙은 유한 예산 루프"로 연구 사이클 전체를 자동화해 80.4%의 과제에서 인간 SOTA를 넘었지만, Method 엄밀성·이득 감소·$3765 비용이라는 세 지점에서 인간 연구와의 경계가 아직 선명하다.
댓글 0
아직 댓글이 없습니다 — 첫 댓글을 남겨보세요.