VERA는 왜 "학습 알고리즘이 아니라 환경"이라고 말하는가 — NVIDIA 에이전트 공동진화 논문 해설
한 문장 요약: 이 글을 읽으면 NVIDIA의 VERA 논문이 검증 가능 환경(Verifiable Environment)을 어떻게 만드는지, 모델과 하네스를 교대 동결 방식으로 함께 진화시키는지, 그리고 그 결과 어떤 수치를 냈는지 이해할 수 있습니다.
1. 왜 이 주제를 알아야 하는가
에이전트 AI의 최종 목표는 "자기 시도에서 배우는 시스템"입니다. 저자는 소프트웨어 엔지니어링·컴퓨터 사용·사무 자동화에서는 진전이 있었지만, 장기 실행(long-horizon) 연구 워크플로우에서는 목표가 아직 실현되지 않았다고 지적합니다. 의료 연구 에이전트의 예를 들면, 이미지에서 소견을 근거화하고 분류하고 보고서를 쓰는 수십 단계의 의존적 워크플로우에서 "초기의 하나의 실수가 전체 워크플로우를 무효화"합니다.
"We argue that the bottleneck is not the learning algorithm but the environment." — 저자는 병목이 학습 알고리즘이 아니라 환경이라고 주장한다 [01_2610.05923v1.pdf Page1]
기존 환경 구축 방식은 두 갈래인데, 둘 다 장기 실행 업무에서 무너집니다. 수동 구축 파이프라인은 테스트 스위트로 성공을 정의해 에피소드 끝만 채점하고, 벤치마크는 수작업으로 큐레이션된 정적 평가 세트라 중간 단계를 재개할 수 없습니다. 저자가 진단한 구조적 결함은 "no precise verifiable environments" — 단계 수준의 검증된 증거가 없어 자기진화 루프가 정밀한 실패로부터 이득을 볼 수 없다는 것입니다.
2. 핵심 메시지 3가지
① 벤치마크 트래젝터리가 곧 검증 환경의 원재료다
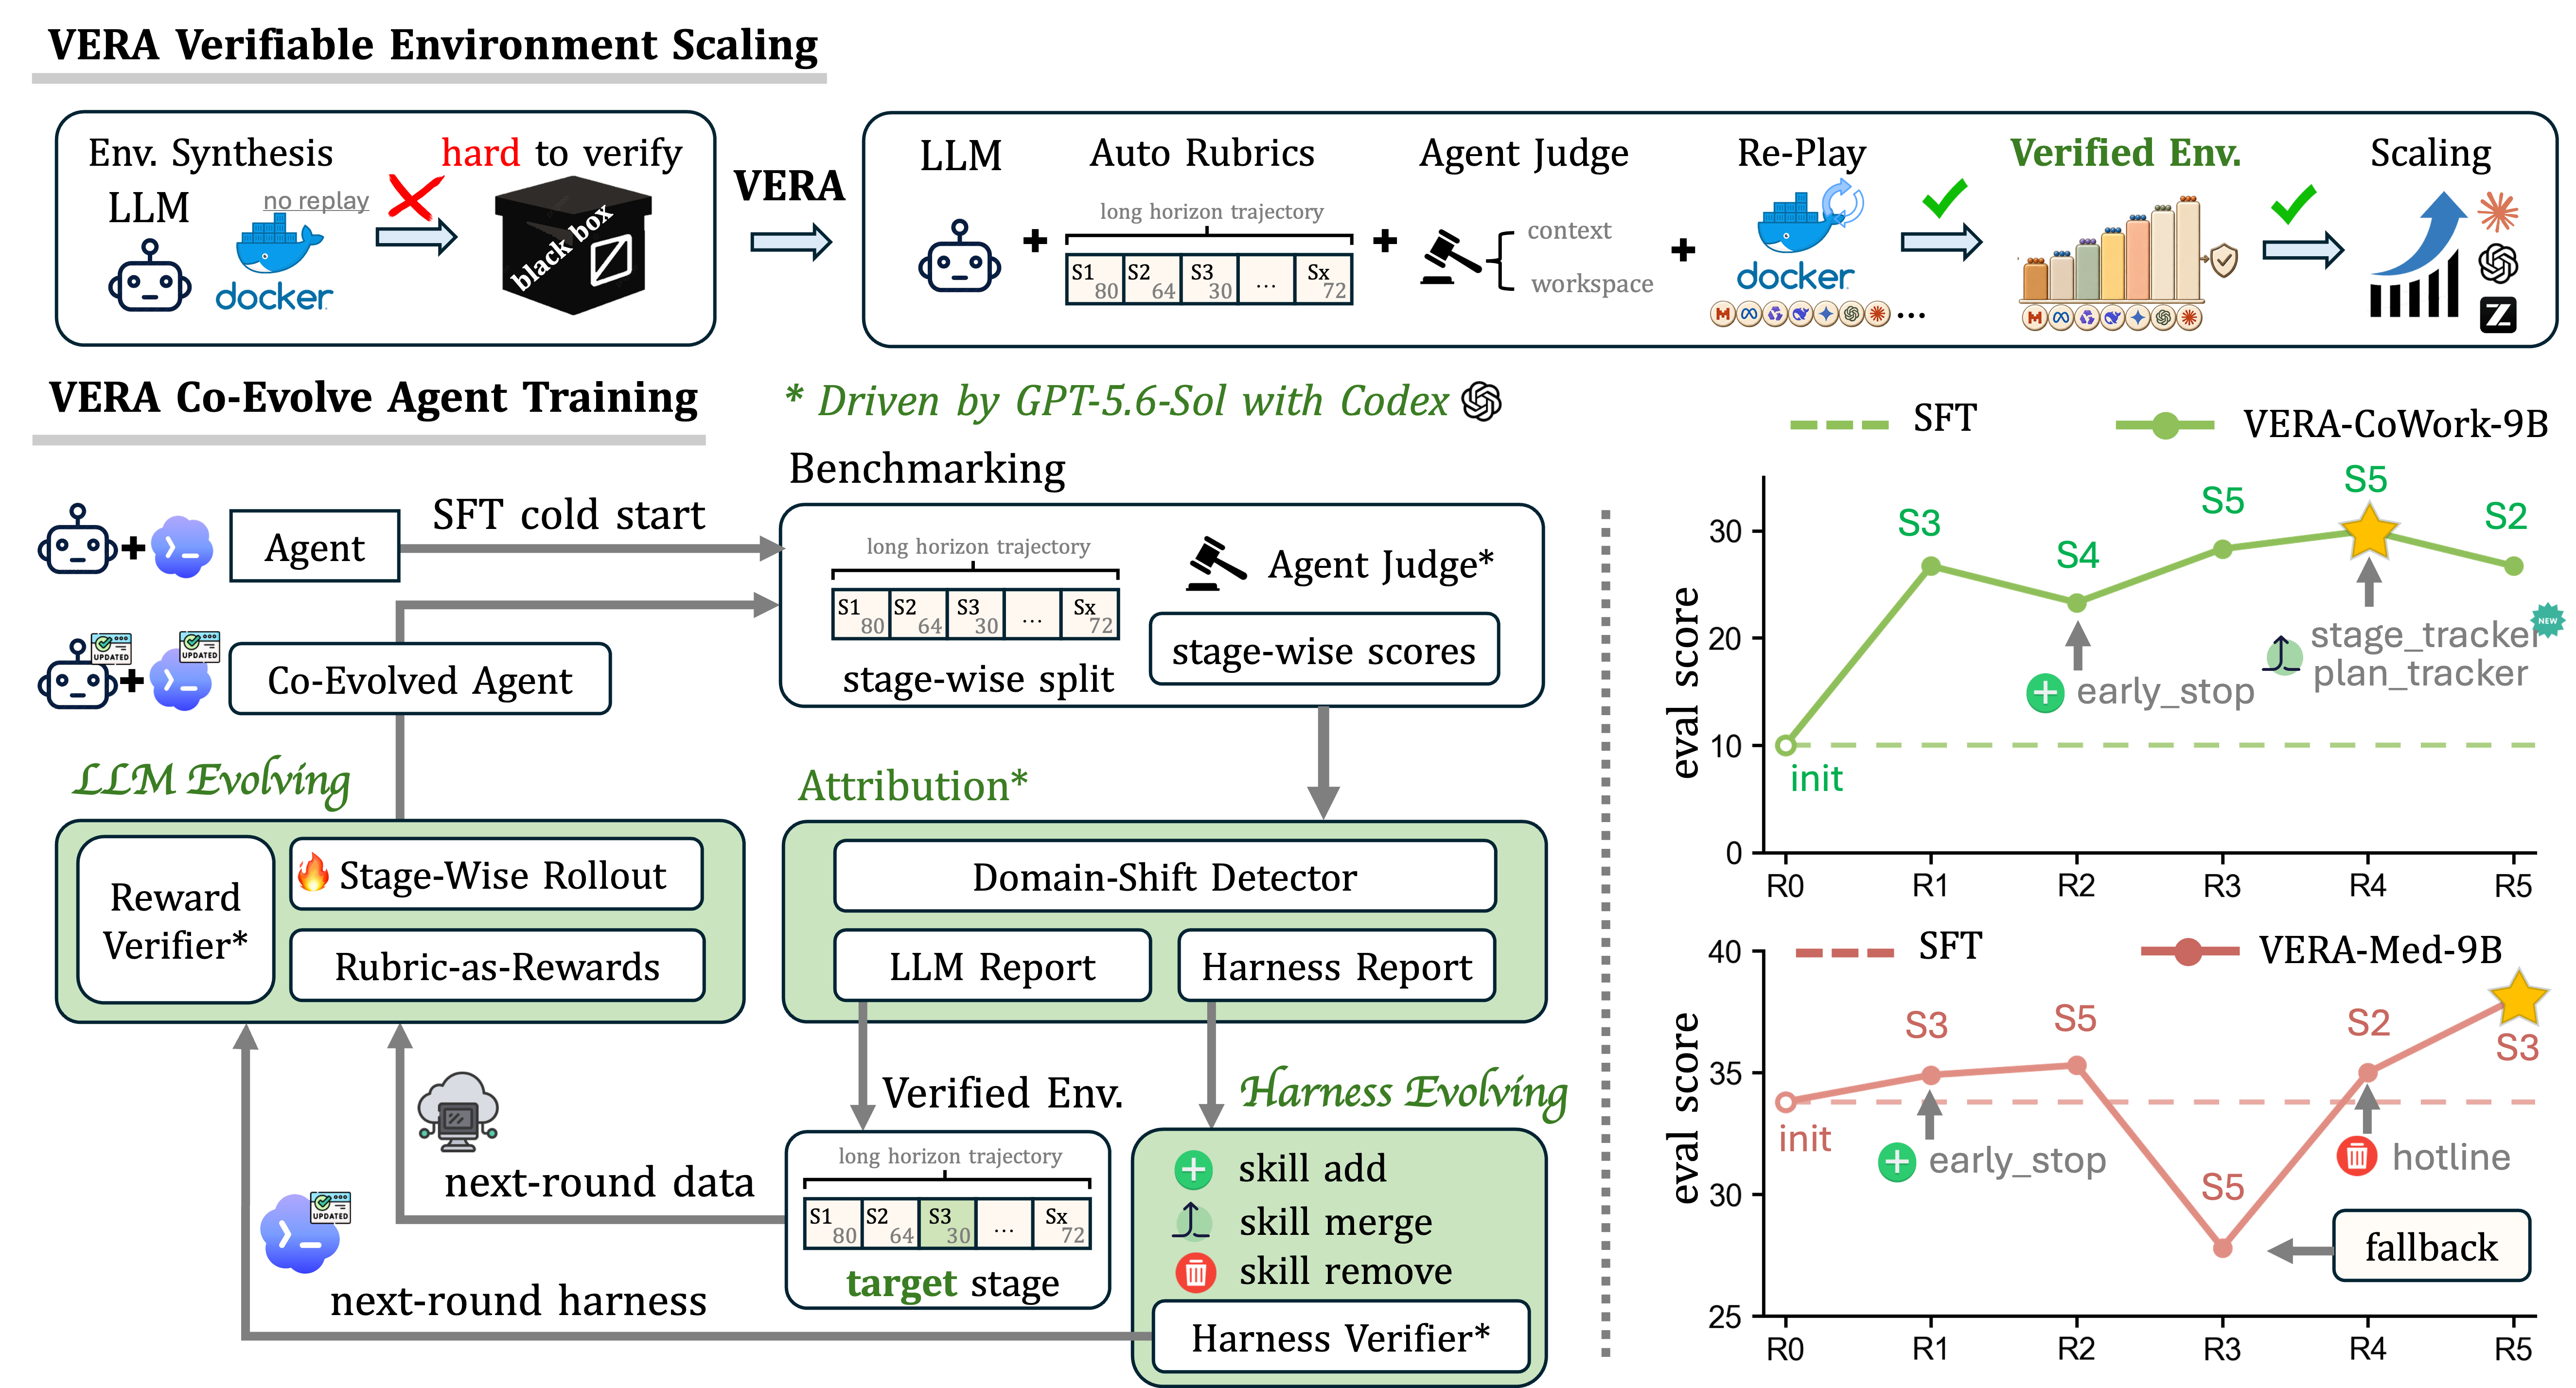
저자의 출발 관찰은 "benchmark trajectories already contain everything a verifiable environment starts with: initial states, tool interactions, and their observable effects"라는 것입니다. 데이터 파이프라인 AUTO-RUBRIC이 이런 트래젝터리를 재시작 가능한 훈련 샌드박스로 변환합니다.
② 한 번에 한 축만 바꾼다 — 그래서 원인이 명확하다
VERA 루프는 LLM과 하네스(스킬·도구·실행 규칙)를 교대 라운드로 개선합니다. "Model training freezes the harness; harness testing freezes the model; rubrics and verifiers stay fixed within a round." — 모델 학습 중에는 하네스를 동결하고, 하네스 테스트 중에는 모델을 동결하며, 한 라운드 안에서는 루브릭과 검증기가 고정됩니다. 따라서 어떤 이득이든 단일 축에 귀속될 수 있습니다.
③ 검증을 통과한 환경만, 검증을 통과한 수정만 살아남는다
코딩 에이전트가 {0, 1} 이진 루브릭을 쓰고, 실행 가능한 코드 검사와 Agent Judge가 워크스페이스를 점검하며, 실행 가능한 검사가 실패하면 Judge 점수를 무효화합니다("a failed executable check overrides any judge score"). 이 채택 루프(admission loop)가 코퍼스와 이후 보상을 리워드 해킹에 강하게 만듭니다.
3. VERA는 무엇을 만들었는가
| 항목 | 내용 |
|---|---|
| 정식 명칭 | VERA (Verifiable Environments for Agentic co-Evolution) |
| 소속 | Nvidia, UC Santa Cruz, UIUC, NUS, Tsinghua, Xian Jiaotong, UPenn |
| 공개 자원 | 9,000+ 검증 가능 장기 실행 훈련 환경 코퍼스 (오픈소스) |
| 백본 스케일 | 4B → 9B → 27B |
| 평가 도메인 | CoWork(자동화) · MedResearch(의료 연구) |
저자는 "we build the first large-scale verifiable environments for the joint self-evolution of an LLM and its harness"라고 주장하며, 기여를 세 가지로 요약합니다 — ① 재시작·루브릭 채점 샌드박스로의 전환, ② LLM-하네스 공동진화, ③ 9,000+ 환경과 27B 백본까지의 확장 [01_2610.05923v1.pdf Page2].
4. AUTO-RUBRIC: 트래젝터리를 검증 환경으로 바꾸는 법
작동 단계
① 샌드박스 구성 — 검증된 환경(도구·워크스페이스·초기 상태) + 과제 쿼리 + 재개용 상호작용 이력
↓
② 루브릭 생성 — 코딩 에이전트가 스킬 설정·도구 API 문서·실행 로그를 읽고 {0,1} 이진 항목을 작성 (행동 인자, 실행 효과, 산출물, 출력 품질 대상)
↓
③ 이중 검증 — 실행 가능한 코드 검사(스킬/도구 스키마, 복원 상태, 결정적 출력) + Agent Judge의 워크스페이스 점검. 실패한 실행 검사가 Judge 점수를 오버라이드
↓
④ 5단계 분할 — plan → setup → verify → execute → submit (S1–S5). 각 단계는 시작 시점 워크스페이스를 복원해 독립적으로 연습·채점
↓
⑤ 훈련 뱅크 편입 — 검증을 통과한 샌드박스만 입장
성립 조건과 예외: 단계별 샌드박스는 각 단계 시작 상태를 복원하는 반면, 엔드투엔드 샌드박스는 전체 워크플로우를 유지하되 LLM 대리모델이 시간 소모적 도구 호출을 대신 응답합니다(Ren et al., 2025). 5단계 분할은 BaT(Liu et al., 2026a)의 단계별 의료 훈련에서 영감을 받았고, 저자는 이를 코딩·의료 양 도메인으로 확장해 전이를 탐색했다고 서술합니다.
5. 공동진화 루프: 교대 동결과 수용 조건
루프의 두 축
| 축 | 동결 대상 | 갱신 내용 | 수용 조건 |
|---|---|---|---|
| 모델 갱신 | 하네스 동결 | 전파라미터 GRPO, 루브릭 점수를 보상으로 | 개발 벤치마크 점수가 이전 수용 체크포인트 대비 20% 이하 감소면 수용, 아니면 fallback |
| 하네스 갱신 | 모델 동결 | 스킬 추가·병합·제거 (도구·실행 규칙은 고정) | 동결 모델 페어드 런으로 타깃 단계 개선 + 엔드투엔드 회귀 없음 + 안전 검사 통과, 추가로 Overall 개발 점수 최소 5% p 향상, 라운드당 최대 3개 수정만 수용 |
핵심 수식 (원문 표기 그대로):
- 단계 보상: r_k = h_k · (Σ_j w_{k,j} z_{k,j}) / (Σ_j w_{k,j}) — h_k ∈ {0, 1}은 필수 검사 전체 통과 여부. 즉 필수 검사가 하나라도 실패하면 그 단계는 0점입니다.
- 엔드투엔드 보상: R_e2e = g [λp + (1 − λ)c] — p는 프로세스 점수, c ∈ {0, 1}은 검증된 완료 신호, g ∈ {0, 1}은 트래젝터리 수준 하드 게이트.
- 도메인별 설정 예외: CoWork는 p를 5개 단계 보상의 평균으로 두고 λ=0.2, g=1로 설정합니다. MedResearch는 p를 Judge가 채점한 프로세스 점수로 두고 λ=0.5, 검증된 리워드 해킹 또는 하드 게이트 실패 시 g=0으로 설정합니다.
Attribution 메커니즘: 라운드 시작 시 개발 과제를 평가하고, LLM Attribution이 단계별 점수와 실행 트레이스를 읽어 LLM Report(가장 잦은 모델 귀속 실패가 있는 타깃 단계 선정)와 Harness Report(누락·오도성 절차 목록)를 생성합니다. 인프라 실패는 제외됩니다. 저자는 이 설계가 세 가지 문제를 해결한다고 주장합니다 — 보상이 테스트가 아니라 실제 행위에서 나오고, 장기 과제가 단계별로 채점되며, 한 번에 한 부분만 바뀌어 모든 이득에 명확한 증거가 남는다는 것입니다.
6. 성능 결과: 단일 축 대비 얼마큼 앞서는가
9B 베이스라인 비교 (Table 2, Qwen3.5-9B 기반)
| 방법 | 유형 | AutoCoWork O | AutoMed O | SWE-Bench P@1 | MedXpertQA P@1 |
|---|---|---|---|---|---|
| ADAS (Hu et al., 2025) | 하네스만 | 20.7 | 55.5 | 52.4 | 42.0 |
| GRPO (Shao et al., 2024) | LLM만 | 5.8 | 36.3 | 14.8 | 22.3 |
| COS-PLAY (Wu et al., 2026b) | 공동진화 | 19.9 | 26.4 | 51.8 | 30.4 |
| Ours (VERA Agent) | 공동진화+검증 | 31.0 | 69.1 | 54.2 | 50.8 |
- AutoCoWorkBench: 31.0 — 가장 강한 단일 축 베이스라인 ADAS(20.7)를 10.3점 초과
- AutoMedBench: 69.1 — 하네스 전용 변형(56.1) 대비 13.0점 초과
- 저자는 이 결과가 단계 채점 워크플로우와 최종 과제 평가 양쪽에서 검증된 공동진화의 효과를 뒷받침한다고 서술합니다 [01_2610.05923v1.pdf Page1]
27B 스케일링과 프론티어 비교
| 규모 | CoWork VERA / Base | Med VERA / Base |
|---|---|---|
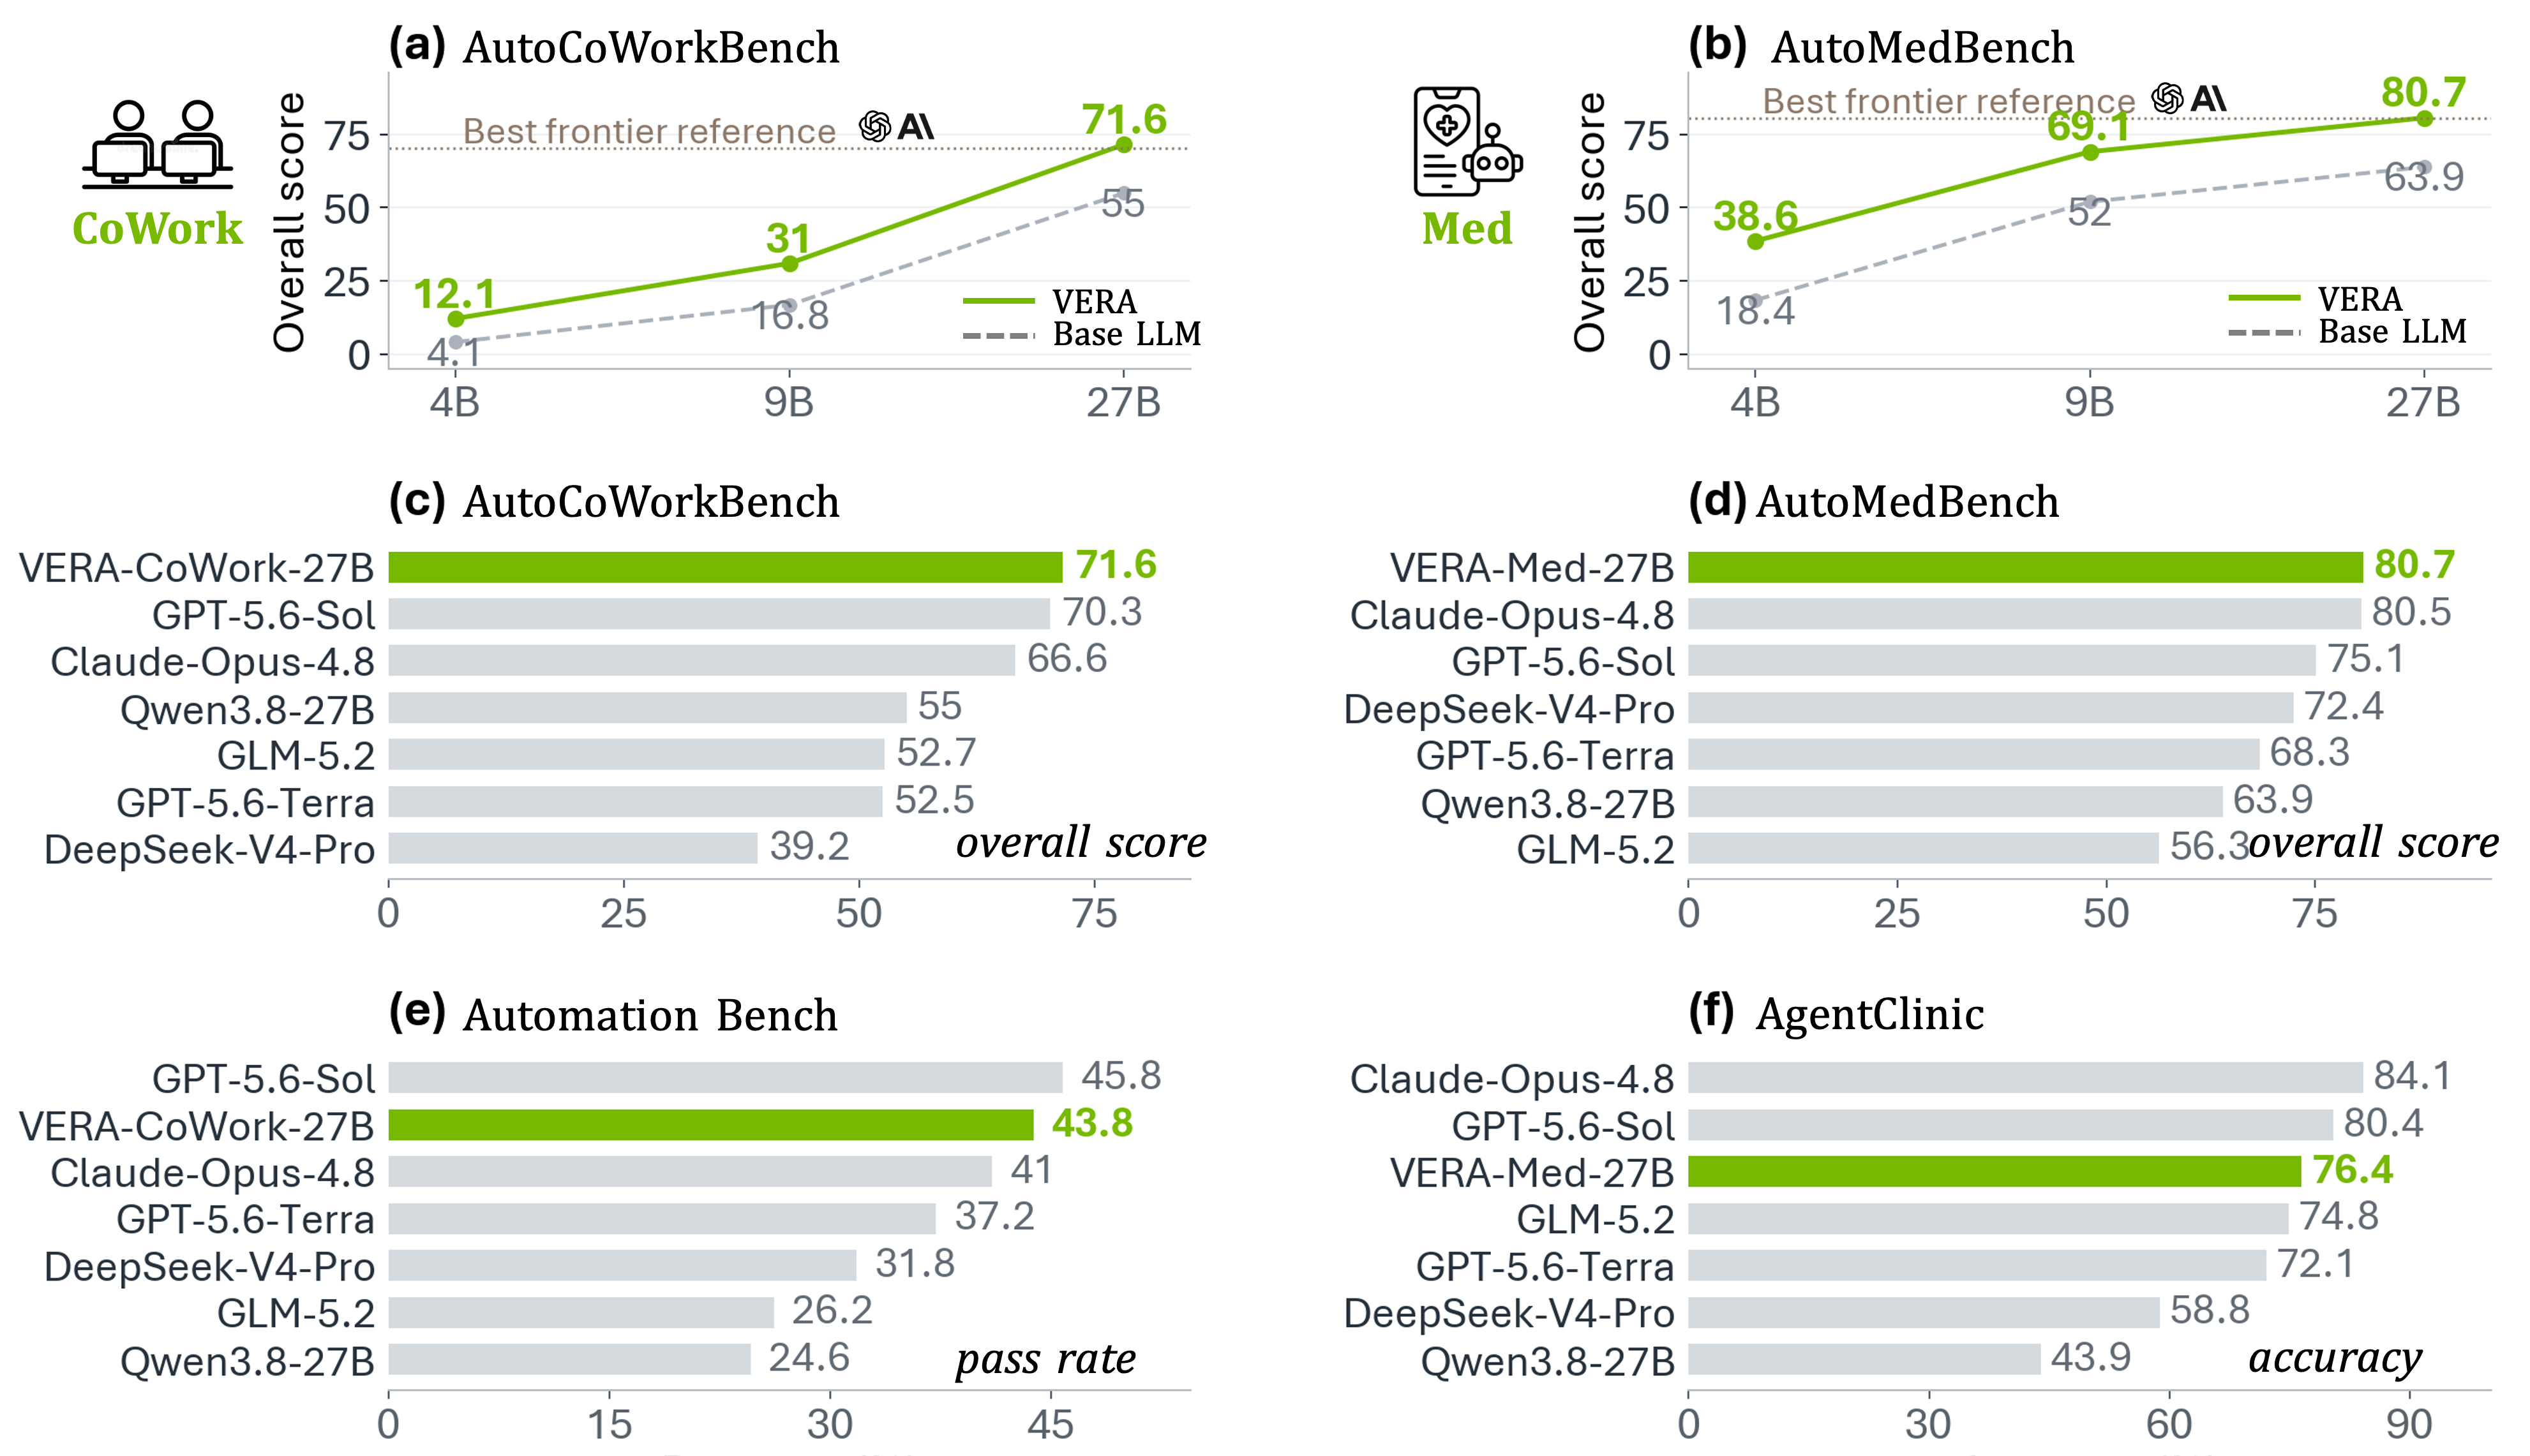
| 4B | 12.1 / 4.1 | 38.6 / 18.4 |
| 9B | 31 / 16.8 | 69.1 / 52 |
| 27B | 71.6 / 55 | 80.7 / 63.9 |
27B에서 VERA-CoWork-27B는 AutoCoWorkBench에서 GPT-5.6-Sol(70.3)·Claude-Opus-4.8(66.6)을 제치고 71.6으로 1위, AutoMedBench에서는 Claude-Opus-4.8(80.5)에 0.2점 앞선 80.7을 기록합니다. 다만 논문 표제·본문은 AutoMedBench 관련 최선의 프론티어 베이스라인과의 격차를 "within 1.2 Overall points"로 표기하고 있어, 표 수치와 문구 간 기준 차이가 있어 보입니다(확인 필요).
전이와 일반 능력
- Automation-Bench(public 600): 베이스 에이전트 대비 19.2%p 향상, 비교 시스템 중 2위
- AgentClinic: 베이스 대비 32.5%p 향상, 비교 시스템 중 3위
- 일반 능력(ALFWorld, IF-Bench, GPQA-Diamond, AIME 2026 등)은 27B에서만 유지·대부분 향상 — 저자는 더 강한 백본이 광역 능력을 희생하지 않고 자기진화를 더 잘 지지한다고 해석합니다.
선행·후속 연구와의 균형: Table 1 기준으로 VERA는 비교 대상 중 유일하게 Weights·Harness·Reward·Verification 네 항목이 모두 ✓인 방법입니다. 다만 이는 구성 요소의 유무 비교이며, ADAS는 하네스 진화에서, GRPO·RaR·OPD·ReflectRL은 LLM 진화에서 각각 검증된 기여를 하고, COS-PLAY는 공동진화를 먼저 제시한 선행 연구입니다. 저자도 COS-PLAY가 양쪽을 함께 진화시킨다는 사실을 인정하면서, 차이를 "verified evidence의 유무"로 한정합니다. 또한 모델 갱신 라운드는 Agent Lightning(Luo et al., 2025)의 실행/학습 분리를 따르며, 옵티마이저·예산은 GRPO 베이스라인과 동일하게 두고 학습 신호(루브릭 보상)만 다르게 했습니다.
7. 한계: 저자가 스스로 밝힌 5가지
논문의 Limitations 섹션은 다섯 가지를 남겨둡니다.
- 환경 스케일링 — 환경 수를 변형하거나 구축 방법을 비교하지 않음
- 하네스 어블레이션 — reasoning effort 등 런타임 설정이 고정되어 소거 실험 없음
- Judge 의존성 — 판정·검증·Attribution이 GPT-5.6-Sol에 의존. 실행 가능한 검사가 판단을 제약하지만, Judge 선택에 대한 민감도는 미검증
- 베이스라인 규모 — 전체 베이스라인 비교는 9B에 한정. 27B 공동진화 1회 실행 비용은 약 5,000-8,000 GPU-hours
- 비교 범위 — 학습 알고리즘을 비교할 뿐, VERA 내부의 대체 보상 공식·갱신 연산자는 별도로 어블레이션하지 않음 (Rubrics-as-Rewards는 루프에서 고정)
8. 관점 포인트 — 실무자가 짚어야 할 것
- 환경이 병목이면 채점 설계가 곧 보상 설계입니다. r_k의 하드 게이트(h_k)처럼 "필수 검사 실패 = 0점" 구조가 리워드 해킹 방지의 1차 방어선입니다.
- 교대 동결은 귀속 가능성의 대가입니다. 한 라운드에 두 축을 동시에 바꾸면 이득의 원인이 흐려집니다. VERA는 원인 명확성을 위해 속도를 일부러 제약합니다.
- 페어드 런(동일 모델·동일 과제, 수정 유무만 차이)이 하네스 수정의 유일한 증거로 인정됩니다. "스킬을 자주 쓴다"는 증거가 아니라는 것이 논문의 명시적 입장입니다.
- 수용 문턱을 숫자로 고정하세요. 모델은 개발 점수 20% 이내 감소 허용, 하네스는 5% p 이상 향상 + 라운드당 최대 3개 — 추상적 기준이 아니라 수치 조건입니다.
- 스케일링의 전제를 확인하세요. 일반 능력 유지가 27B에서만 관측됐고, 베이스라인 비교는 9B에 한정돼 있습니다.
9. 최종 핵심 정리
확인해야 할 핵심 질문:
- ✅ VERA가 해결하는 구조적 결함은 무엇인가? — 단계 수준 검증 증거의 부재
- ✅ 환경은 어떻게 만들어지는가? — AUTO-RUBRIC: 이진 루브릭 + 이중 검사 + 5단계 재시작 샌드박스
- ✅ 공동진화는 어떻게 검증되는가? — 교대 동결 + 페어드 런 + 개발셋 수용 기준(20% / 5% p / 라운드당 3개)
- ✅ 핵심 수치는? — 9B에서 +10.3 / +13.0점, 27B에서 71.6 / 80.7, 환경 9,000+ 공개
- ✅ 가장 큰 한계는? — Judge(GPT-5.6-Sol) 의존, 9B 한정 베이스라인, 27B 실행 비용 5,000-8,000 GPU-hours
한 줄 요약: VERA는 "좋은 알고리즘보다 좋은 환경"이라는 전제 아래, 트래젝터리를 검증 가능한 샌드박스로 바꾸고 모델과 하네스를 한 번에 한 축씩 교대 진화시켜, 9B에서 단일 축 베이스라인을 10.3·13.0점 따돌린 첫 대규모 검증 환경 공동진화 사례다.
댓글 0
아직 댓글이 없습니다 — 첫 댓글을 남겨보세요.