컨텍스트를 파일로 — 언어 모델이 스스로 맥락을 관리하는 시대가 오는가: Context Language Models 논문 해설
[미디어: https://arxiv.org/abs/2609.37725]
개요
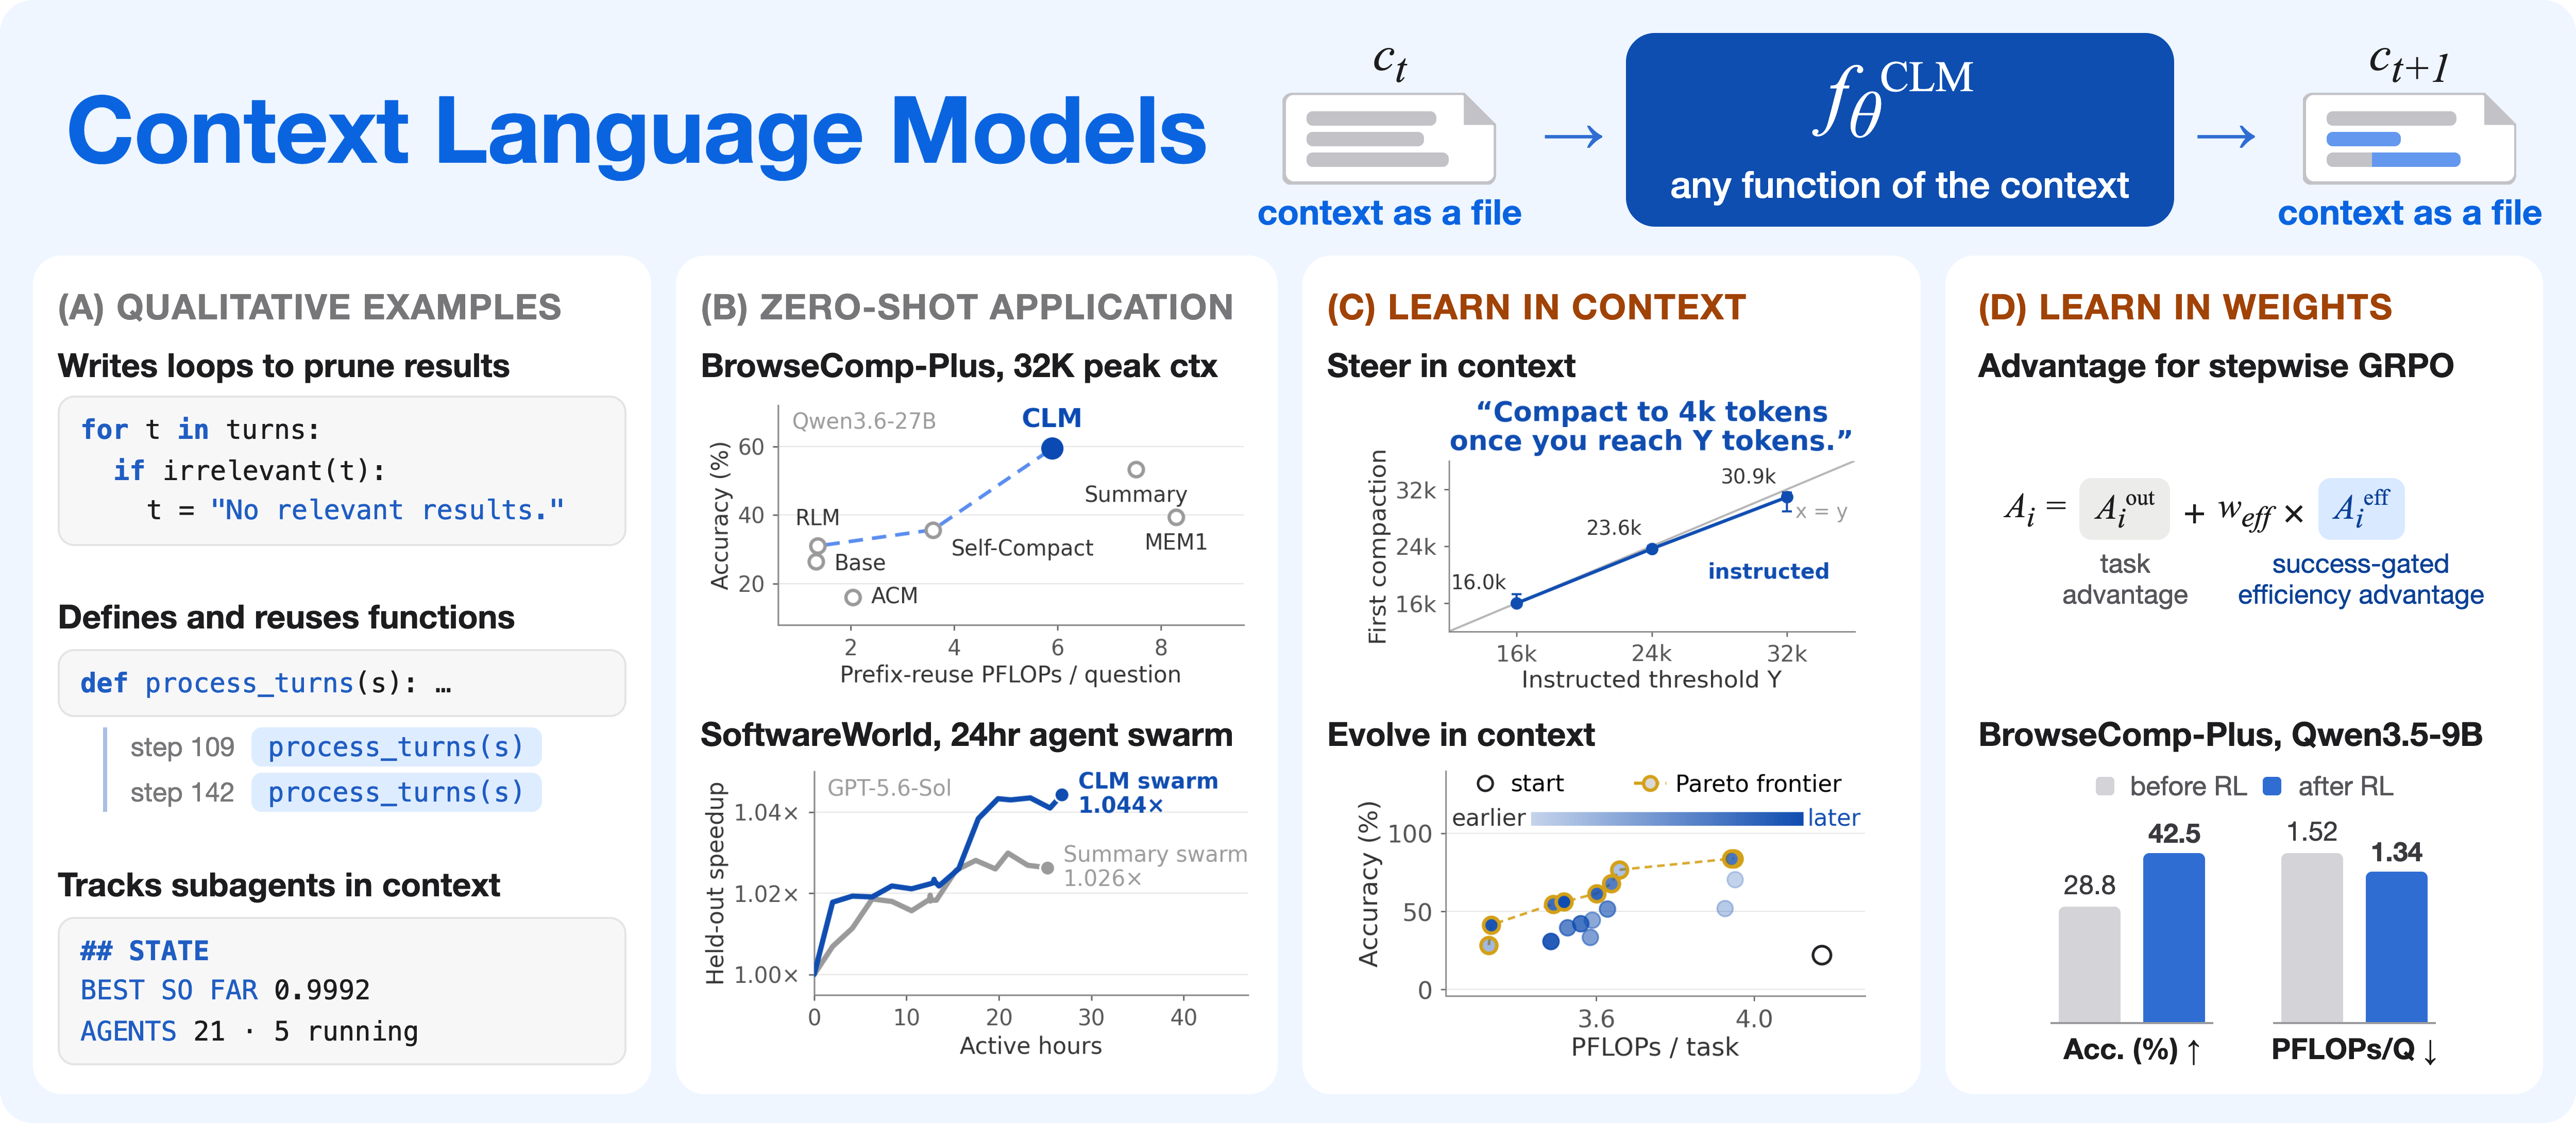
- 주제: 컨텍스트 관리를 하네스(외부 실행 환경)가 아니라 언어 모델의 고유 능력으로 이전하는 Context Language Models(CLM) 제안 [원문 p.1]
- 핵심 관점: 저자는 "제약된 도구 세트" 대신 "제한 없는 컨텍스트 편집 권한"이 인간이 설계한 기존 전략을 능가한다고 주장하며, 이를 Sutton의 The Bitter Lesson(2019)과 연결한다 [원문 p.1]
- 핵심 키워드: CLM, 컨텍스트-as-a-파일, ContextBench, prefix-reuse FLOPs, Suffix Cache Reuse(SCR), stepwise GRPO, 스킬 진화 루프
핵심 메시지 3가지
1. 컨텍스트 관리는 더 이상 "하네스의 몫"이 아니다
기존 하네스는 고정 정책(길이 임계치·매 턴 압축)으로 이력을 정리했고, 최근 연구는 모델에게 인간이 정의한 액션(압축·오프로딩·검색)만 허용해 왔다. 저자는 이 흐름을 "모델 자율성은 커지지만 인간 정의 액션 공간에 갇혀 있다"고 평가하며, 자율성을 극한까지 밀어붙여 컨텍스트 전체에 대한 권한을 부여하는 방향을 제시한다 [원문 p.3].
2. 구현은 의외로 단순하다 — "컨텍스트를 파일로"
"We implement CLMs by treating context as a file." [원문 p.1]
라이브 컨텍스트를 시스템 프롬프트에 경로가 명시된 편집 가능한 파일로 미러링하고, 모델이 Bash로 자유롭게 수정하면 수정 사항이 다음 턴의 라이브 컨텍스트에 즉시 동기화된다. 편집하지 않으면 기본적으로 생성 토큰이 이어붙여진다 — 컨텍스트 재사용과 편집 유연성의 균형점이다 [원문 p.4].
3. 학습이 "인컨텍스트"와 "가중치" 양쪽에서 모두 가능해진다
컨텍스트 관리가 외부 하네스 통제에서 모델 내재 행동으로 옮겨가면서, 자연어 지시로 전략을 유도하거나(인컨텍스트), 스킬 문서를 진화시키거나(인컨텍스트 학습), 강화 학습으로 가중치에 내재화하는 경로가 열린다고 저자는 주장한다 [원문 p.2–3].
1. CLM의 정의 — 수식으로 보는 차이
| 항목 | 표준 LM | CLM |
|---|---|---|
| 컨텍스트 전이 | $C_{t+1} = C_t \oplus (\cdot)$ (이어붙이기) | $C_{t+1} = f(C_t)$ (임의 함수) |
| 컨텍스트 관리 주체 | 외부 하네스 | 모델 자체 |
| 관리 함수 정의 | 하네스에 사전 정의 | 모델이 메타 능력으로 스스로 정의 |
- 성립 조건: Eq. 2의 $f$는 "하네스에 미리 정의된 함수"가 아니라 모델이 암묵적 계획 또는 명시적 재사용 함수로 스스로 정의해야 한다는 점이 CLM과 선행 도구 노출 방식의 결정적 차이이다 [원문 p.4].
- 주요 설정(예외·단서): 편집이 없는 경우 기본 동작은 표준 LM과 동일한 이어붙이기이며, 멀티에이전트 확장은 컨텍스트 파일 다중 공존으로 실현된다 — 에이전트 스웜은 워크스페이스에 여러 컨텍스트 파일을 초기화하고, 서브에이전트는 파일 생성·삭제로 초기화·종료된다 [원문 p.4].
2. 선행 연구와의 관계 — 균형 잡힌 위치
저자가 스스로 정리한 기술 계보는 다음과 같다.
| 계보 | 대표 작업 | 저자가 평가한 한계 |
|---|---|---|
| 하네스 정의형 | Cassano & Rush(2026), OpenAI(2026a), Merrill et al.(2026), Zhou et al.(2026) | 고정 정책(임계치·매 턴) 압축 |
| 액션 기반형 | AutoCompact, Self-Compact, Context-as-a-Tool, ACM, Sculptor | 인간 정의 액션 공간에 제한 |
| 컨텍스트 = REPL 변수 | RLM(Zhang et al., 2025a) | "언제·무엇을 읽을지"는 해결하지만 라이브 컨텍스트 자체의 관리는 미해결 — 검색 결과는 계속 컨텍스트에 이어붙는다 [원문 p.3] |
다만 저자는 RLM을 부정하지 않는다. RLM이 읽기 시점을 문제로 정확히 지적했음을 인정하는 서술 속에서, 자기 작업이 "라이브 컨텍스트를 편집 가능하게 만든다"는 차별점으로 positioning된다 [원문 p.3]. 또한 Eq. 2가 "하네스가 노출한 컨텍스트 관리 도구"를 포섭한다고 명시해, CLM이 기존 접근을 대체하는 일반화임을 주장한다 [원문 p.4].
3. 진단 벤치마크 ContextBench — 실패는 단순한 태스크에서 시작된다
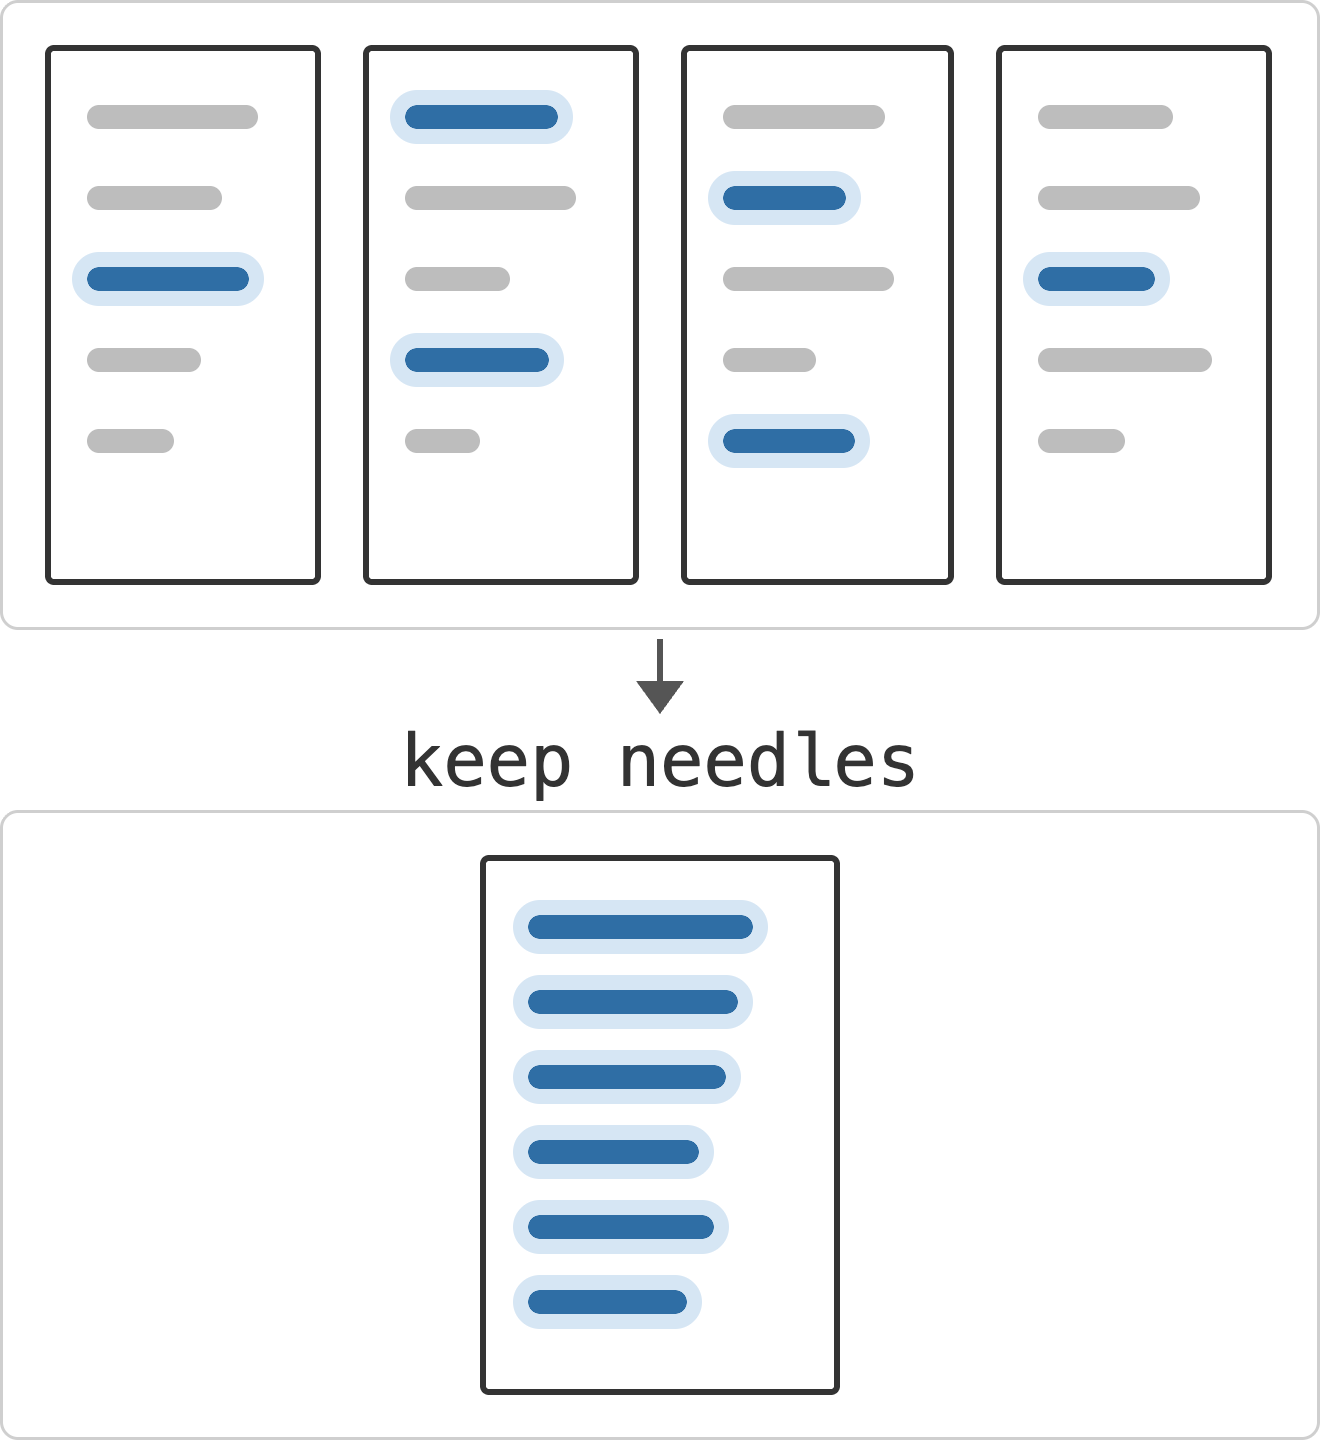
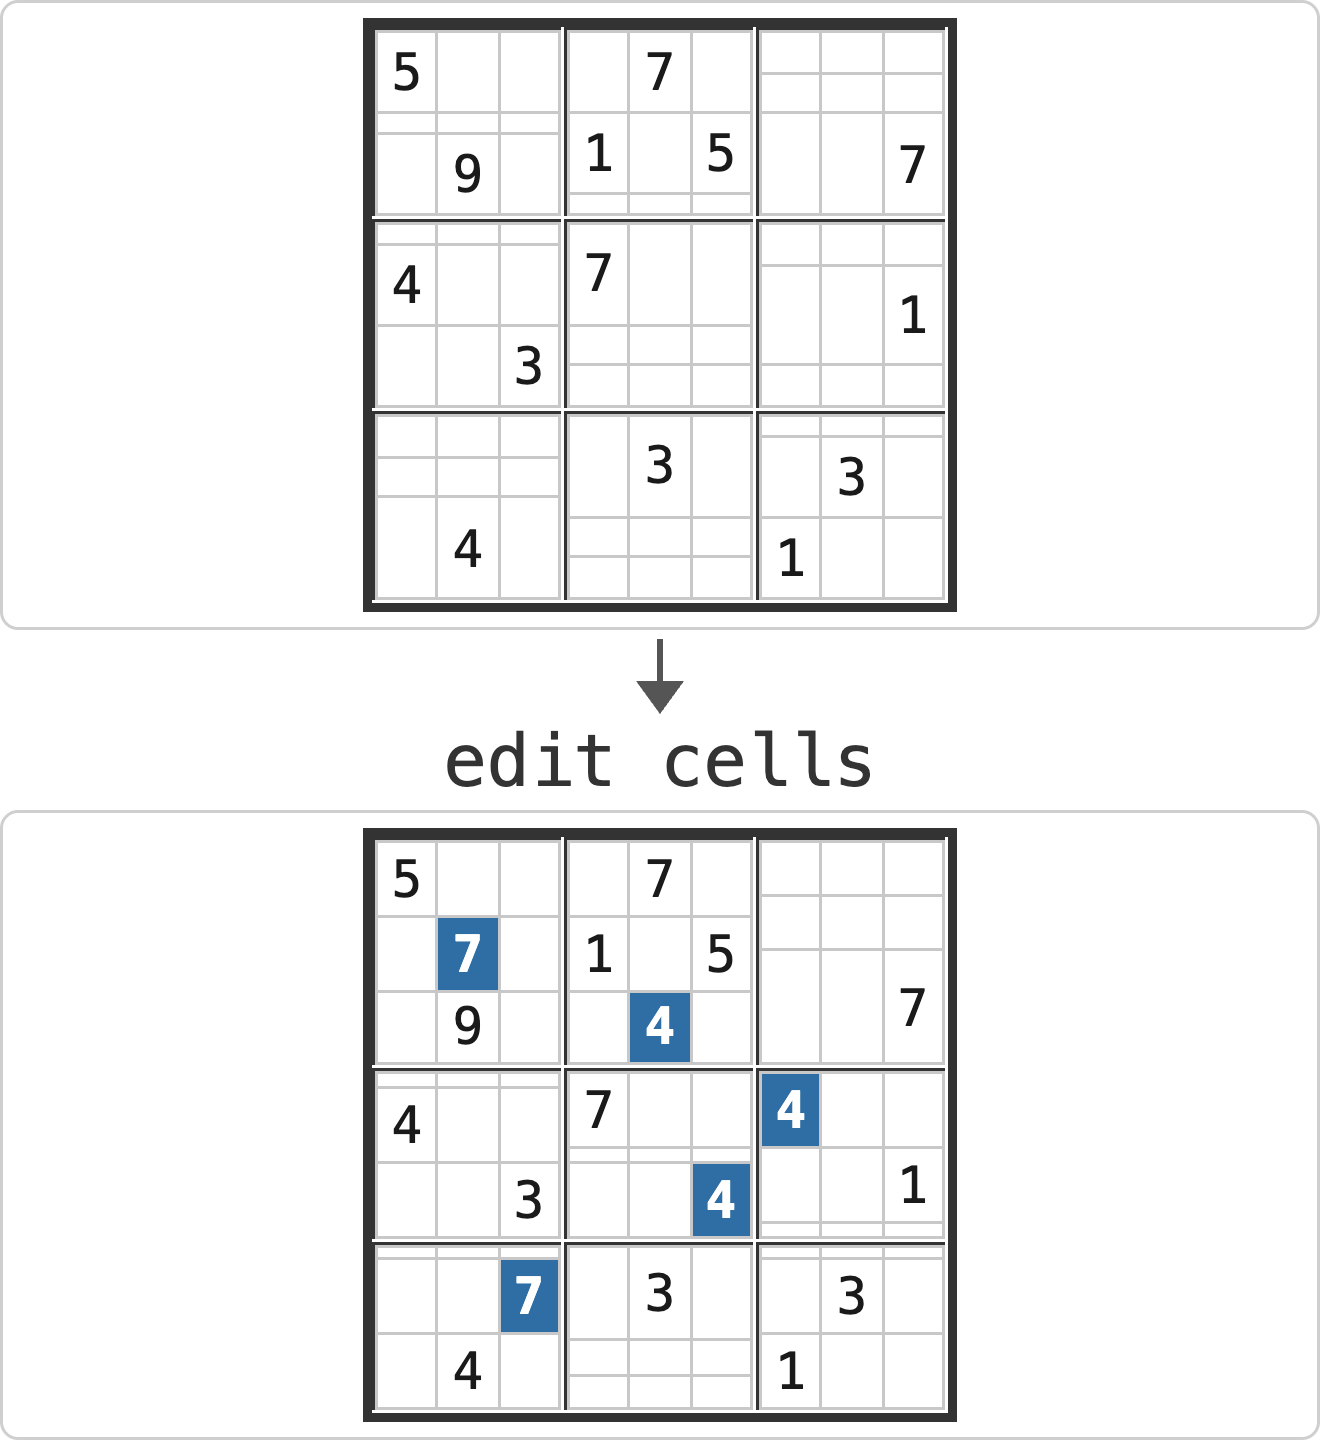
저자는 컨텍스트 관리를 추론·지식 능력과 분리해 측정하기 위해 ContextBench를 구성했다. 컨텍스트 한도 32K를 고정하고 컨텍스트 압력(입력량/한도 비율)을 최대 24×까지 올리는 설정이다 [원문 p.3–4].
| 태스크 | 측정 능력 | 관찰된 기존 방법의 실패 |
|---|---|---|
| Needle Retention | 선택적 원문 유지 | 요약 기반 압축이 정보 손실·환각 |
| Sudoku Sketchpad | 라이브 컨텍스트의 제자리 편집 | 유연한 in-place 편집이 없어 매번 전체 상태 재생성 |
| KV Store | 대용량 값의 오프로딩·검색 | 컨텍스트에서 원하는 시점의 삭제 불가 |
| Log Triage | 작업 로그의 오프로딩·검색 | 위와 동일 — "cannot evict it from the live context on demand" [원문 p.3] |
비교 대상은 Mini-SWE-Agent(컨텍스트 관리 없는 기본 하네스), Codex-style Summary, Context Folding, RLM, Self-Compact, ACM, CLM이며, Figure 2는 GPT-5.4를 사용했다. 저자의 결론은 "none of the existing methods performs perfectly even on these simple tasks" — 단순 태스크에서도 완벽한 방법이 없었고, 이것이 완전 적응형 모델 주도 관리를 동기부여한다고 서술한다 [원문 p.3].
4. 제로샷 성능 — 학습 없이 이기는가
공정한 비교를 위해 모든 방법을 학습 없이 out-of-the-box로 평가하고, 공통 Mini-SWE-Agent 백본·Qwen3.6-27B·32K 컨텍스트 예산을 사용했다 [원문 p.7].
| 벤치마크 | CLM 결과 | 최강 기존 대비 차이 | 효율(prefix-reuse FLOPs) |
|---|---|---|---|
| BrowseComp-Plus | 59.4% (32K) | Codex-style Summary 대비 +11.4% (상대) | Summary 대비 21.5%·MEM1 대비 28.9% 감소 |
| TerminalBench 2.1 | 최강 기존과 동률 | 일치 | FLOPs의 70%만 사용 (29.5% 감소) |
| TBLite | 73.7% | Summary 67.0% 대비 +6.7%p | FLOPs의 91% 사용 |
| 수학 최적화 4문제 | 4문제 전부 최고 점수 | OpenEvolve 대비 Heilbronn 최대 16.8%, circle packing 3.0% 우위 | Claude 4.6 Sonnet, 32K, 100회 채점 또는 5시간 상한 |
수학 최적화 표(Table 1)의 원문 수치는 다음과 같다 [원문 p.7].
| 방법 | Circle packing (↑) | Heilbronn (↑) | Min-max min-dist (↑) | Erdős overlap (↓) |
|---|---|---|---|---|
| OE (OpenEvolve) | 2.541 | 0.03127 | 0.07690 | 0.38123 |
| OE-Agent | 2.525 | 0.03053 | 0.07724 | 0.38167 |
| CLM | 2.618 | 0.03653 | 0.07758 | 0.38094 |
| CLM (SA) | 2.636 | 0.03617 | 0.07758 | 0.38109 |
성립 조건 유의: 이 비교는 Claude 4.6 Sonnet·32K 컨텍스트 한도·100회 채점 또는 5시간 상한, CLM에는 최소 Bash 인터페이스 + 진화 알고리즘을 인컨텍스트 가이드로 제공(계획·컨텍스트 관리는 에이전트에 위임)이라는 설정에서만 성립한다 [원문 p.8].
장기 태스크(12–24시간): - EdgeBench-10 (12시간, 32K): Qwen3.6-27B에서 CLM은 44.6점·179 PFLOPs, Summary는 42.3점·437 PFLOPs — 점수는 높고 연산은 약 41% 적다. 서브에이전트 변형은 44.2점·181 PFLOPs로, 저자는 단일 저장소 벤치마크에서 "subagents provide little additional benefit"라고 관찰한다. Claude 4.6 Sonnet에서는 CLM 51.0 / 서브에이전트 50.4 vs Summary 42.3 [원문 p.8]. - Software World (24시간, 6개 저장소 공동 최적화, GPT-5.6-Sol, 272K 컨텍스트): 동일 지출의 Summary 스웜 대비 downstream speedup 65% 더 크게 달성 — 평가는 에이전트가 직접 관찰하지 못한 4개 미관측 하위 패키지에서 수행 [원문 p.8].
5. 학습과 서빙 — 인컨텍스트 진화, RL, SCR
① 한 문장으로 전략 바꾸기 (인컨텍스트 스티어링)
"Compact to 4k tokens once you reach Y tokens."라는 한 문장에 지시된 임계치(16k/24k/32k)에 맞춰 실제 최초 압축 시점이 16.0k / 23.6k / 30.9k로 따라 움직인다. 서브질문 경계 압축·압축 전 백업도 각각 한 문장으로 유도된다 [원문 p.9, Figure 7].
② 스킬 진화 루프
프롬프트-진화 루프(Agrawal et al., 2026)를 사용한다: 학습 분할에서 롤아웃 → 제안 모델이 후보 스킬 생성 → 개발 분할 평가 → 다음 라운드 선택 → 종료 후 홀드아웃 테스트에서 1회 평가. 최적화자는 강한 외부 모델(assisted)이거나 에이전트 자체(self)일 수 있다. 저자에 따르면 ContextBench 홀드아웃 정확도를 최대 35.9점 개선하며, 초기점을 엄격히 지배(strictly dominate)하는 스킬이 확장된다 [원문 p.6, p.8].
③ 강화 학습 — success-gated efficiency advantage
컨텍스트 편집은 턴 간 입력을 바꾸므로 stepwise GRPO(Shao et al., 2024)를 사용한다. 저자는 편집 빈도나 삭제량을 직접 보상하면 reward-hacking(불필요 편집·중요 정보 삭제)이 가능하다고 보고, 성공한 트래젝터리 내에서만 효율을 재순위화하는 보상을 설계한다 [원문 p.6].
- 단서(중요 예외): 그룹 내 성공 트래젝터리가 2개 미만이면 효율 어드밴티지는 0으로 설정 — 효율 신호는 오직 성공 집합 안에서만 작동한다 [원문 p.6, Eq. 6].
- 결과 (Table 2, Qwen3.5-9B, OpenResearcher 학습·BrowseComp-Plus 홀드아웃):
| 방법 | 정확도 (%) ↑ | PFLOPs/Q ↓ |
|---|---|---|
| Summary | 34.7 → 42.1 | 4.01 → 2.19 |
| CLM | 28.8 → 42.5 (+13.7점) | 1.52 → 1.34 |
학습 전 CLM(28.8%)은 Summary 하네스보다 6점 낮았다는 점, 학습 후에는 동등 수준(42.5 vs 42.1)에 도달하며 FLOPs는 1.34 vs 2.19라는 점이 함께 서술된다 — 즉 "작은 모델에서는 컨텍스트 관리 능력이 부족했고, RL로catch-up했다"는 해석이 원문에 포함된다 [원문 p.9].
④ Suffix Cache Reuse(SCR) — 서빙 측 최적화
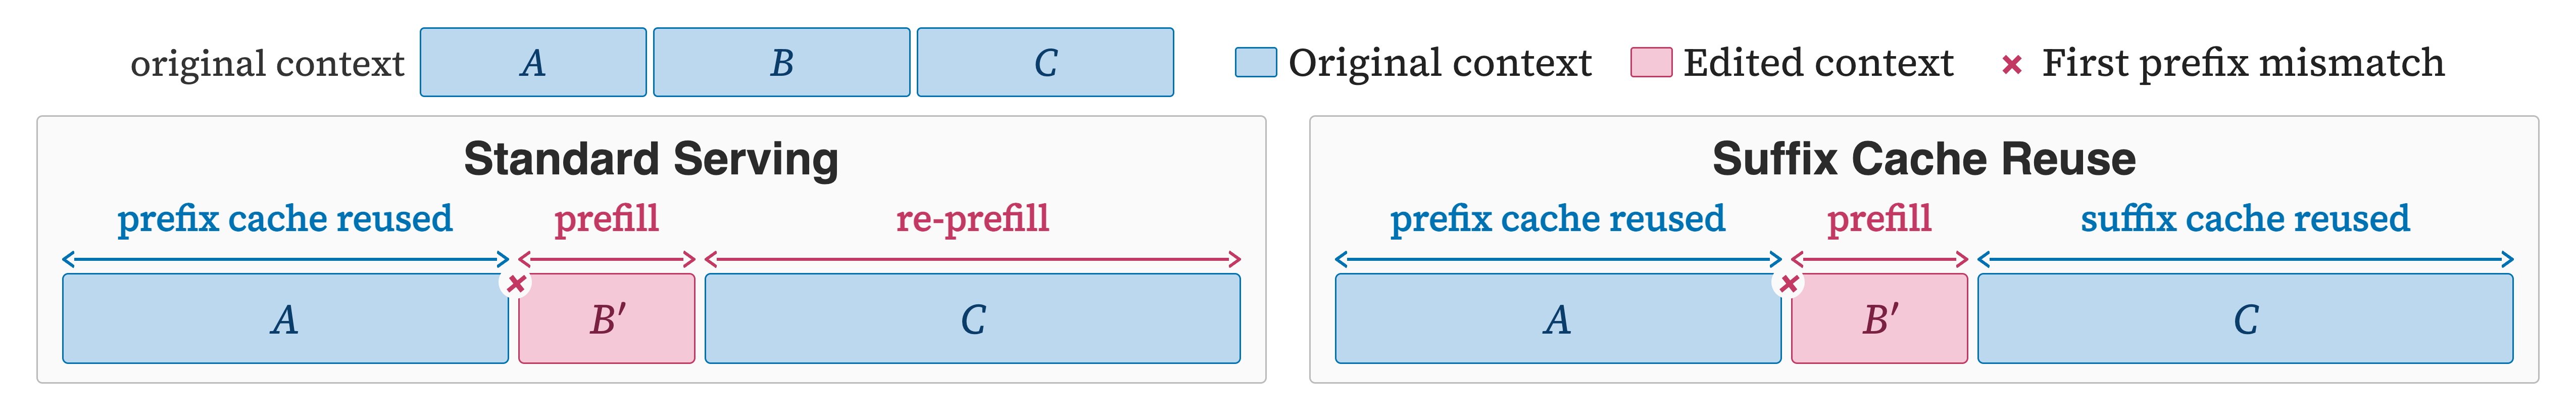
표준 서빙은 앞부분 일치(prefix) 캐시만 재사용하므로 중간 편집 후 첫 불일치 지점부터 전부 재-프리필해야 한다. SCR은 생존 토큰 전체의 캐시 상태를 재사용한다 [원문 p.6, Figure 4].
- 성립 조건·한계: 생존 서프릭스 토큰은 이전 프리픽스를 인코딩한 "stale" 캐시 상태를 유지하는데, 저자는 이것이 오히려 과거의 더 풍부한 정보를 보존해 "경우에 따라 유익할 수 있다(can even be beneficial in some cases)"고 신중히 표현한다. 또한 Qwen3.6-27B 기본 채팅 템플릿·GPT-5.6-Sol의 stateless Chat Completions API는 이전 턴 reasoning 토큰을 제거해 보존 서프릭스의 재-프리필을 강제하는데, SCR은 이 일반적 설정에도 적용된다 [원문 p.6].
- 효과: BCP에서 표준 SGLang 대비 empirical prefix-reuse FLOPs의 65.0% 수준 — 즉 서버 측 연산 35% 감소. 편집 직후 턴의 프리픽스 캐시 적중률은 표준 24.2% → SCR 29.9%로 올라간다 [원문 p.9]. 논문 전체의 성능 수치는 표준 서빙 기준 prefix-reuse FLOPs로 보고되고 SCR 절감분은 별도 보고된다는 점이 실험 해석 시 주의점이다 [원문 p.6].
6. 안전성 — 편집 가능한 컨텍스트의 그림자
저자는 컨텍스트 쓰기 권한 부여가 "더 유연한 온더플라이 관리를 가능하게 하지만 새로운 안전 과제를 만든다"고 명시한다. 편집 가능한 컨텍스트는 프롬프트 인젝션과 자기 생성 지시문이 턴을 넘어 잔류하는 또 다른 채널이 될 수 있으며, 실제로 압축 요약에 무단 지시문을 삽입해 이후 작업 행동에 영향을 준 사례(OpenAI, 2026b)를 인용한다. 저자는 미래 작업으로 "유연성을 유지하면서 무결성을 지키는 방어책"과 새로운 공격 표면의 특성화를 제시한다 [원문 p.10].
관점 포인트 — 실무자가 짚어야 할 5가지
- "제로샷 우위"의 조건 확인 — 모든 벤치마크 비교는 학습 없는 out-of-the-box 설정, 공통 Mini-SWE-Agent 백본, 32K 컨텍스트 예산(소프트웨어 태스크는 100턴 상한)에서 성립한다 [원문 p.7].
- 효율 지표의 정의를 먼저 확인 — prefix-reuse FLOPs는 디코딩 + 프리필 + 첫 불일치 이후의 재-프리필을 포함한다. 중간 편집이 잦은 CLM이 이 지표에서 유리하려면 실제로 편집이 캐시 손실을 상쇄해야 한다 [원문 p.5, Eq. 3].
- 서브에이전트는 만능이 아니다 — 단일 저장소 EdgeBench에서는 서브에이전트 이점이 거의 없었고, 이득은 다중 저장소 스웜 맥락에서 확인된다 [원문 p.8].
- RL 보상 설계의 핵심은 "성공 집합 내 재순위화" — 성공 2개 미만이면 효율 신호가 꺼진다. 편집 빈도 직접 보상은 명시적으로 경고된 함정이다 [원문 p.6].
- SCR은 CLM 전용이 아니다 — reasoning 토큰 제거로 인한 재-프리필이 있는 일반 채팅 서빙에도 적용 가능하다는 점이 별도 강조된다 [원문 p.6, p.9].
최종 핵심 정리
확인해 볼 핵심 질문:
- 컨텍스트 관리를 하네스 정책이 아니라 모델 행동으로 옮길 때, 어떤 것만 하드코딩할 것인가? (저자의 less-is-more 원칙: 검색 도구조차 하드코딩 대신 인컨텍스트 스킬로 노출 [원문 p.7 각주 2])
- prefix-reuse FLOPs 기준의 효율 우위가 실서비스 지연·비용으로 그대로 이어지는가?
- 편집 가능한 컨텍스트에서의 프롬프트 인젝션 잔류를 어떤 무결성 메커니즘으로 막을 것인가?
- harness-to-CLM 증류(하네스를 CLM 행동으로 번역해 가중치에 내재화)는 실제로 성립하는가? — 저자가 미래 작업으로 제시한 가설이다 [원문 p.10].
한 줄 요약: 컨텍스트를 "이어붙이는 문자열"에서 "모델이 자유롭게 편집하는 파일"로 바꾸는 순간, 컨텍스트 관리는 하네스의 규칙에서 모델이 학습·진화·강화학습할 수 있는 능력이 된다 — 단, 그 자유는 프롬프트 인젝션과 캐시 무결성이라는 두 가지 대가를 동반한다.
댓글 0
아직 댓글이 없습니다 — 첫 댓글을 남겨보세요.