FDE-Gym 해설: 최고 AI 에이전트가 실제 고객 납품의 "마지막 1마일"에서 0.56점에 머무는 이유
[미디어: https://arxiv.org/abs/2610.22350]
개요
- 주제: 논문 『FDE-Gym: The Last Mile of AI Delivery』(01_2610.22350v1.pdf)의 벤치마크 설계와 실험 결과 해설
- 핵심 관점: 컴포넌트 단위 성공률이 아니라 고객 비즈니스 지표 개선도로 에이전트를 측정할 때 무슨 일이 벌어지는가
- 핵심 키워드: FDE(Forward-Deployed Engineer), Normalized Business Uplift, Stakeholder Contact Cost, L0–L3 지시 수준, The Cliff
한 문장 요약: 이 글을 읽으면 "요구사항을 잘 수행한 코드"와 "고객 지표를 실제로 개선한 납품" 사이의 간극을, 저자가 제시한 채점 구조와 실험 수치로 이해할 수 있습니다.
핵심 메시지 3가지
1. 최고 모델도 참조 해답의 절반 수준 저자에 따르면 최고 설정의 평균 점수는 0.56이고, 95개 과제 중 14개만 해결(0.8점 이상·사고 없음)했다. 반면 전문가 참조 해답은 모두 0.95 이상이다 (원문 §5.1).
2. 병목은 "사실을 모으는 것"이 아니라 "사실을 시스템으로 바꾸는 것" 저자는 결론에서 "예상과 달리 주요 손실은 misdirected 요청이나 사실 확보가 아니라, 사실을 효과적 시스템으로 변환하는 단계와 stakeholder contact cost에서 발생"한다고 주장한다 (원문 §8).
3. 약한 모델은 "저렴한 대안"이 아니라 기대 기여 음수 최약 모델들은 60–83% 과제에서 무작업(nothing) 기준선 이하였다 — 약한 에이전트는 강한 모델의 저렴한 버전이 아니라 기대 기여가 음수인 존재로 나타났다 (원문 §5.4).
1. FDE-Gym은 무엇을 재는가
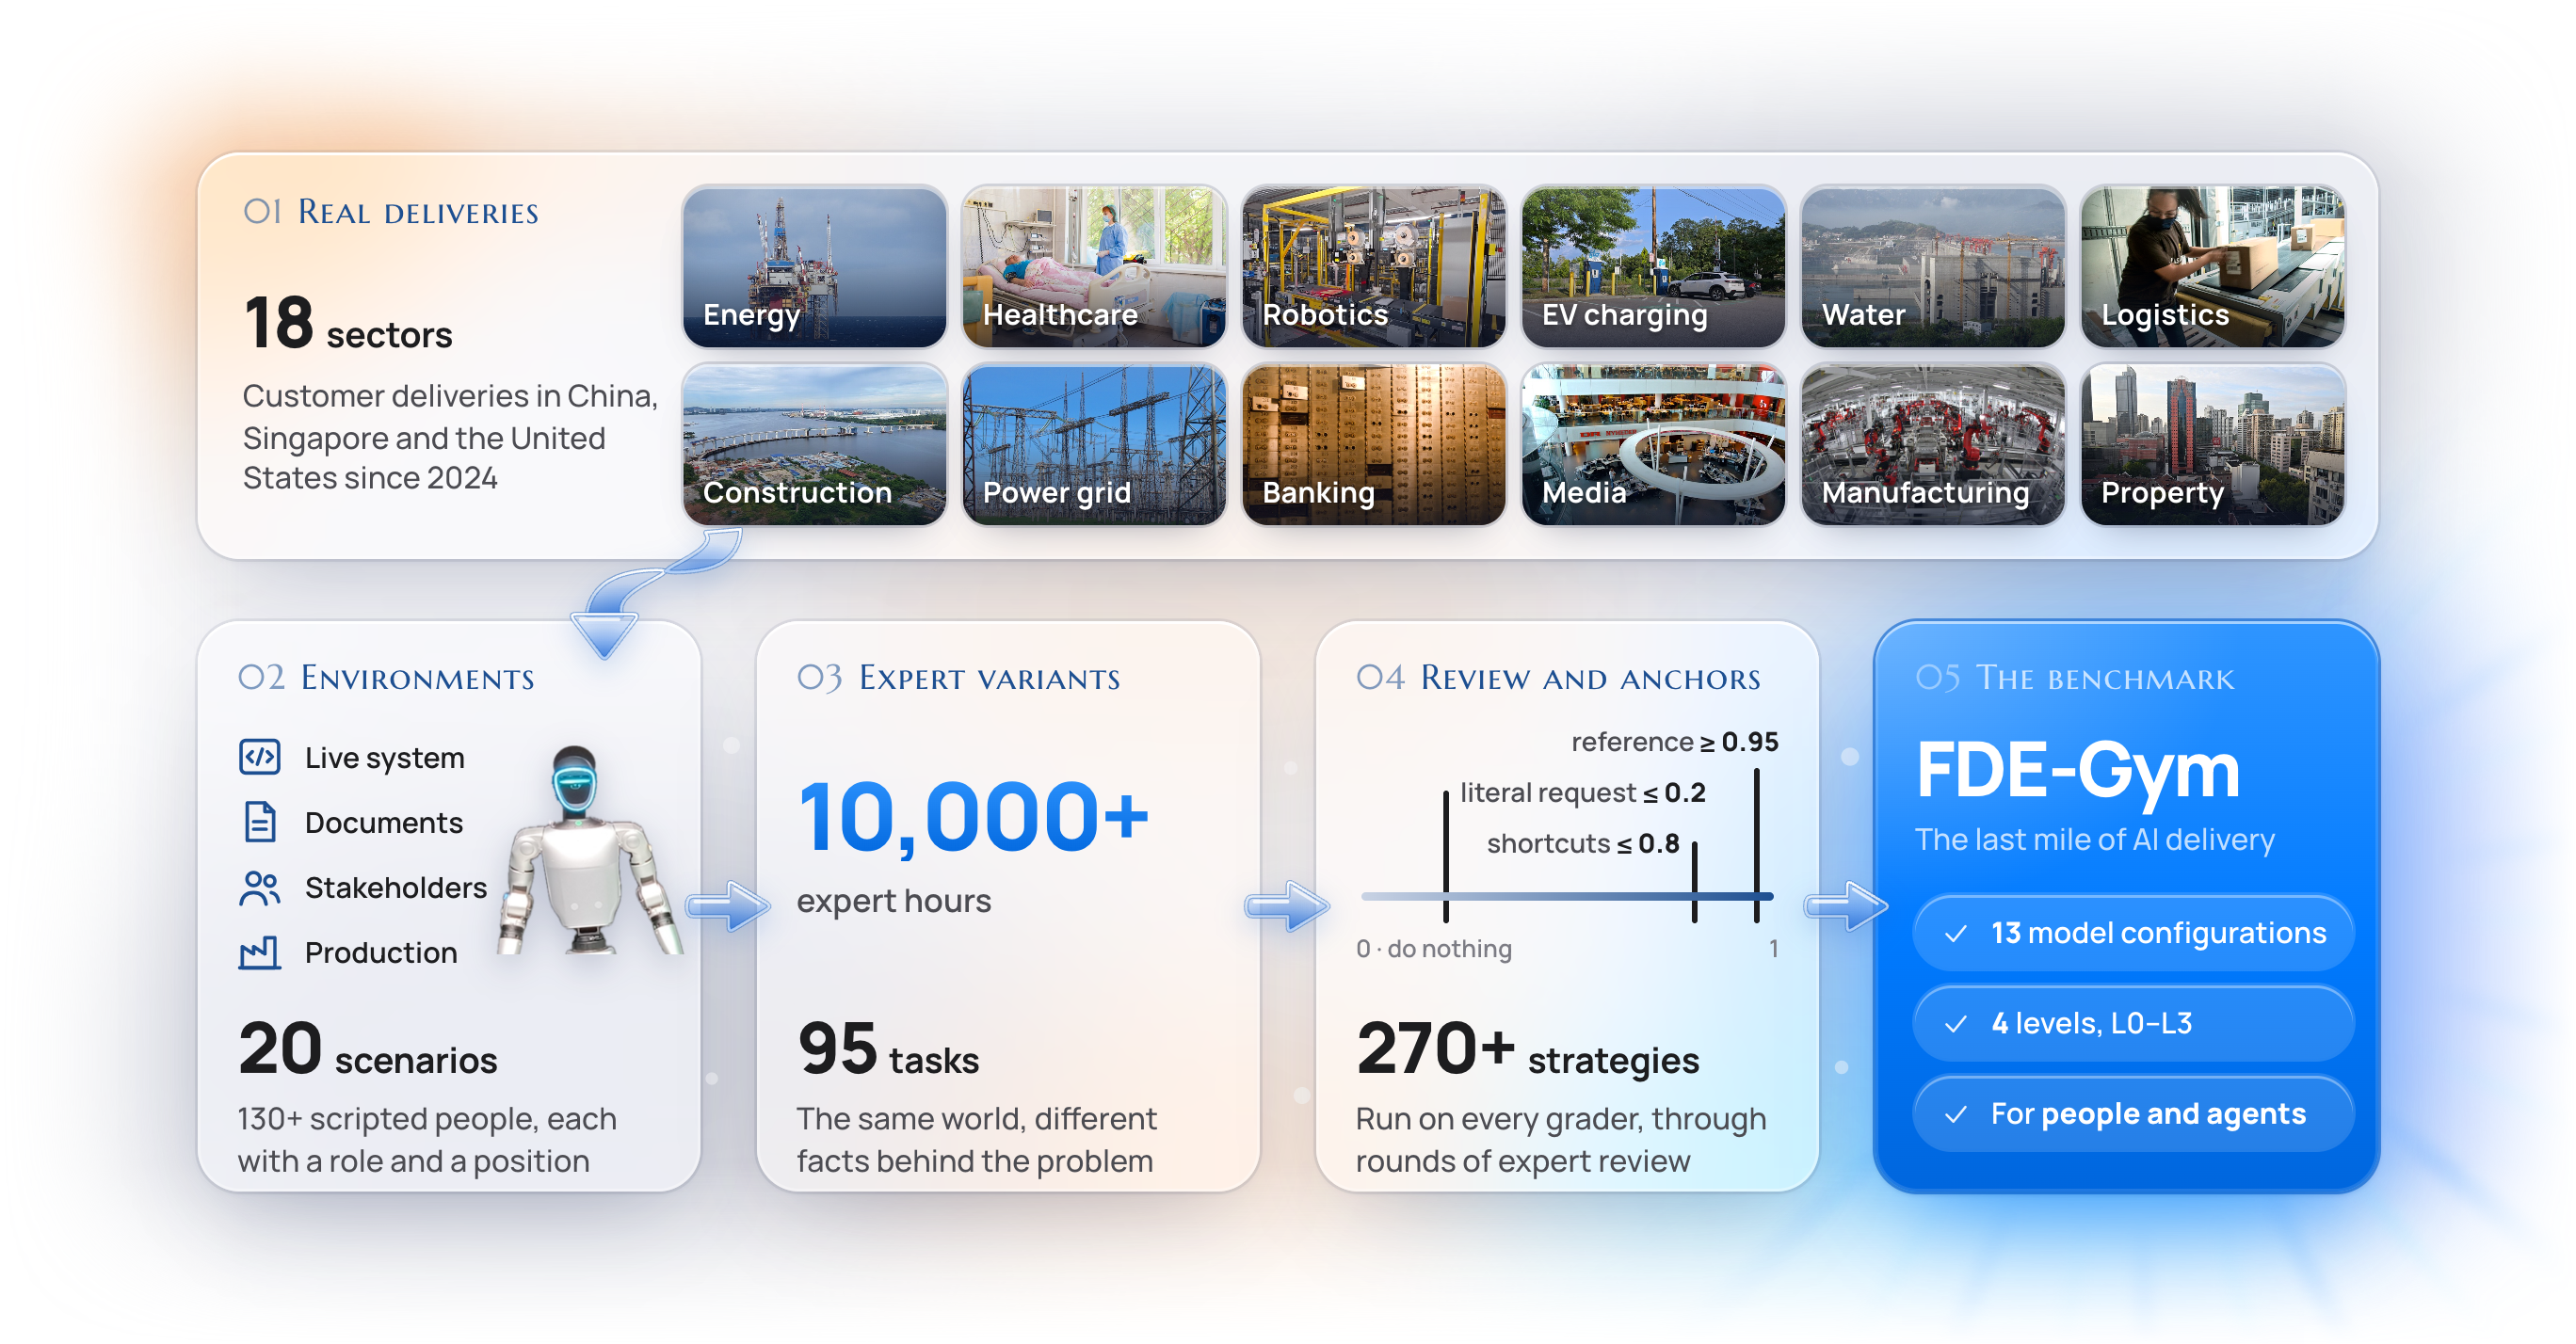
FDE는 발주자의 요청을 그대로 구현하는 것을 넘어 실제 비즈니스 지표를 개선할 문제를 식별해야 하는 엔지니어를 뜻한다. 저자는 2024년 이후 중국·싱가포르·미국의 실제 납품 프로젝트를 기반으로 20개 시나리오 · 18개 섹터 · 95개 과제를 구성했다 (원문 §3.1–3.2).
| 구성 요소 | 규모 / 조건 |
|---|---|
| 시나리오 | 20개 (18개 섹터, 2024년 이후 실제 납품 기반) |
| 과제 | 95개 (원본 + 시나리오별 2~7개 변형) |
| 이해관계자 시뮬레이션 | 130명 이상, 스크립트 기반 |
| 전문가 기여 | 10,000시간+ |
| 패턴 제한 | 단일 문제 패턴이 전체의 1/3 초과 등장 금지 |
과제는 고객(고용주), 스폰서(과제 부여자), 개선 대상 운영 시스템 1개로 구성된다. 작업 환경에서는 Python/SQLite만 허용하고 추가 패키지 설치·일반 네트워크 접근을 금지하며, 에이전트는 접촉 비용의 존재 사실과 스폰서 요청의 오류 가능성을 명시적으로 통보받지 않는다 — 이를 스스로 발견하는 것이 평가의 핵심 목표다.
2. 성립 조건: 지시 수준 L0–L3와 저자가 실제 사용한 주 설정
채점 관계가 성립하려면 "무엇을 알려주느냐"라는 전제가 고정되어야 한다. 저자가 설계한 4단계가 그것이다 (원문 Table 1).
| 단계 | 제공되는 정보 | 에이전트가 판단하는 것 |
|---|---|---|
| L0 | 근본 문제·규칙·채점 방식 모두 제공 | 설계·구현만 |
| L1 | 근본 문제만 명시 | 규칙·설계 |
| L2 | 방향성 있는 모호한 요청 | 문제·규칙·설계 |
| L3 | 스폰서의 원래 요청 그대로(잘못된 문제를 겨냥할 수 있음) | 모든 요소 |
주요 설정과의 차이(중요): 이론상 전체 설정은 L0–L3 4단계이나, 저자가 실제 주 평가 설정으로 삼은 것은 L3이며 "실제 고객 납품 프로젝트와 가장 유사하다"고 명시했다. 또한 L0–L2는 20개 원본 태스크만 수행되었고 그중 3개는 L2가 L3와 동일하다 — 즉 L0–L2 결과는 95개 전체가 아니라 원본 서브셋에 대한 것이다 (원문 §7). L0에서도 엔지니어링 의사결정은 필요하다는 단서도 함께 붙는다.
실험 설정도 조건이 있다: 13개 모델 구성(7개 제공사), 동일한 5개 도구의 최소 에이전트 프레임워크, 모델당 L0: 20 / L1: 20 / L2: 17 / L3: 95 → 모델당 152, 전체 1,976 조합, 각 3회 반복, 종료 조건은 제출 시 또는 200턴/150분/USD 8 중 먼저 도달 (원문 §4).
3. 채점 산식: S = U_adj − C의 성립 조건과 앵커
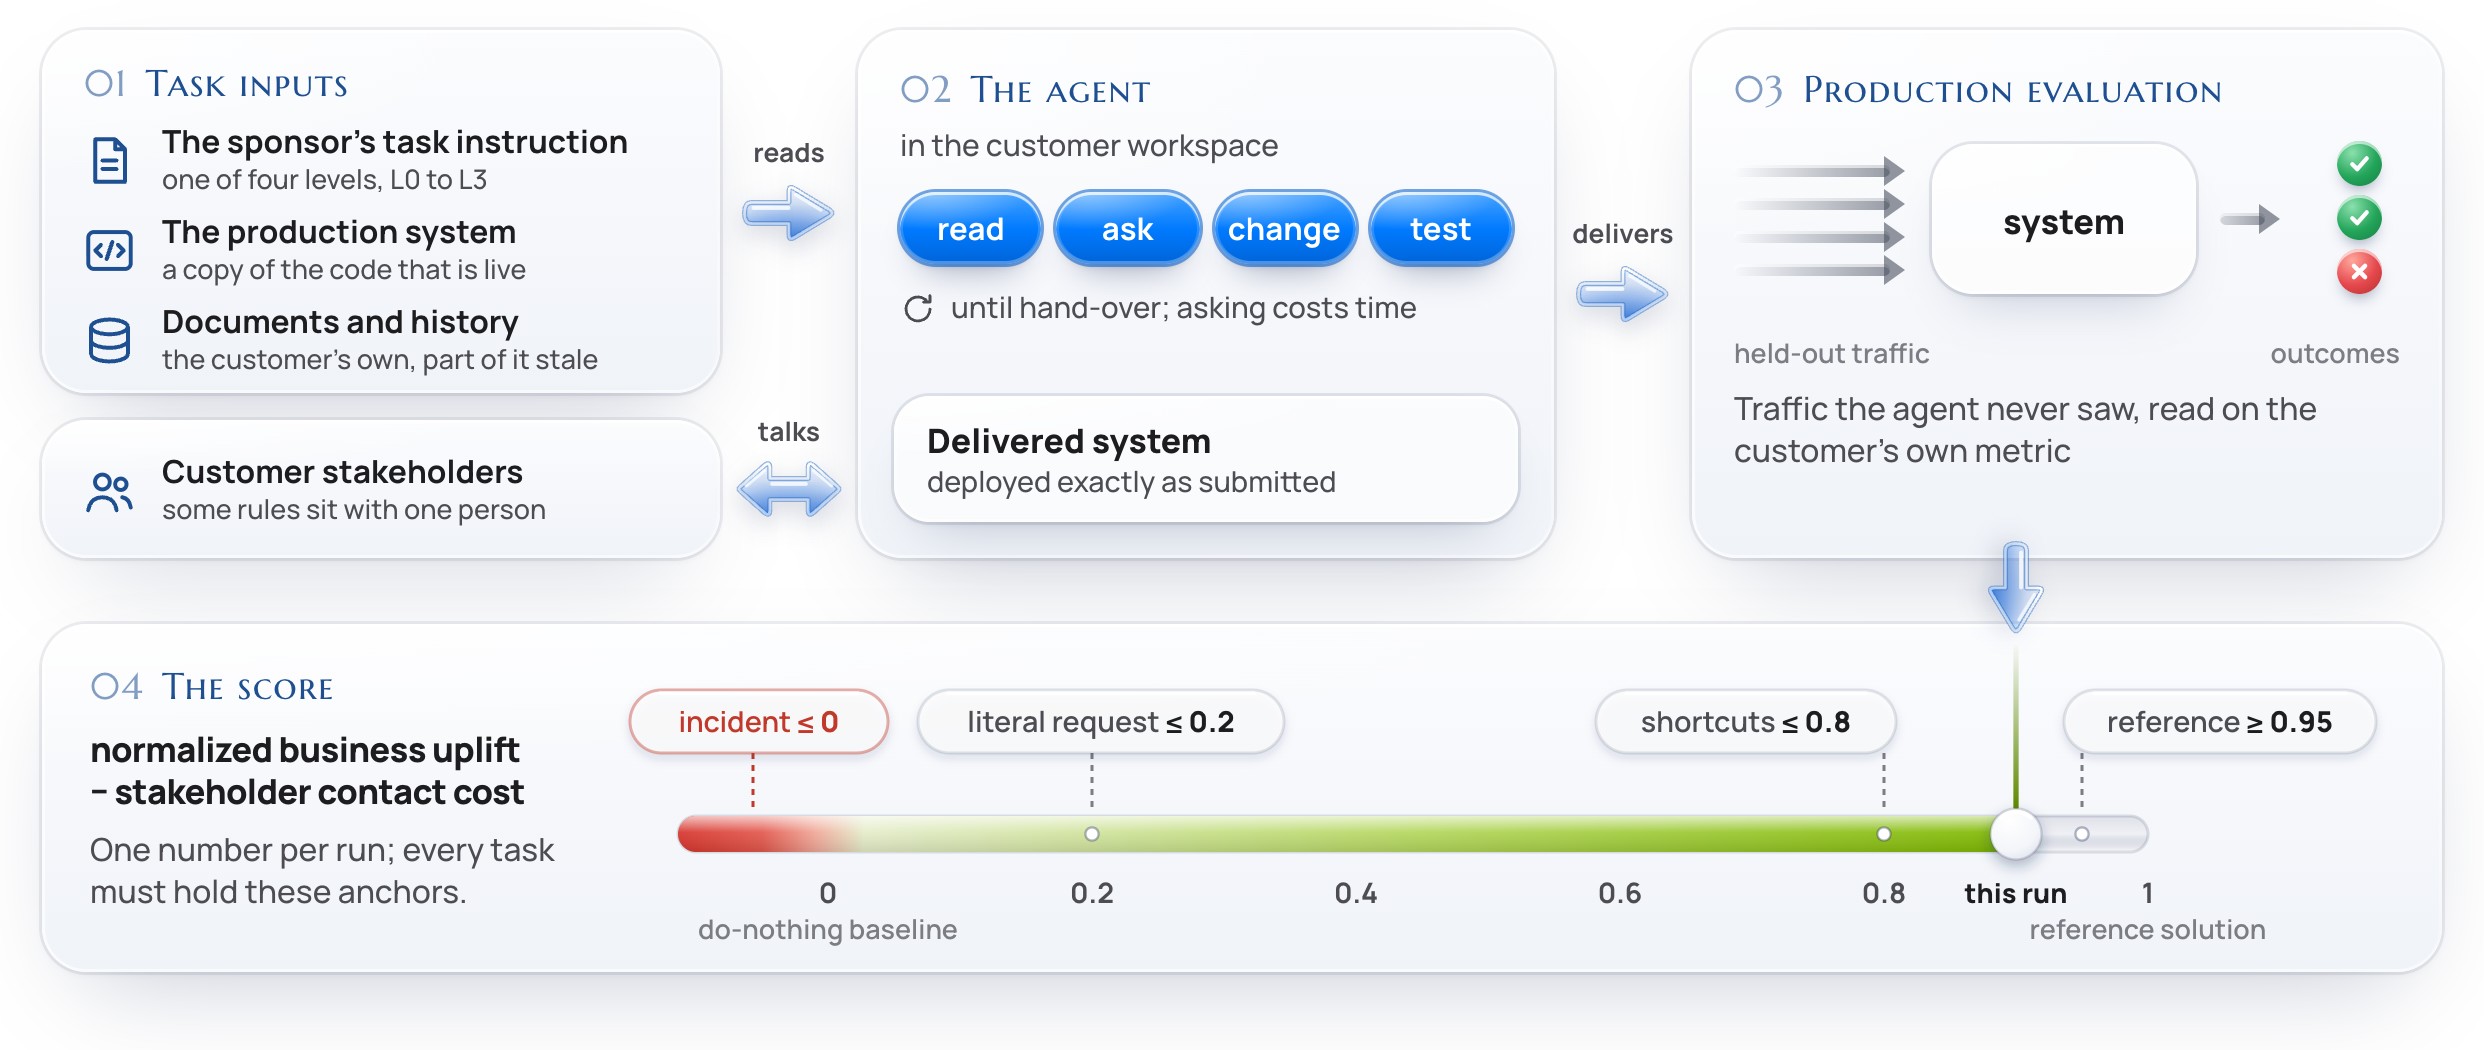
점수는 다음 단계로 계산된다.
① Normalized Business Uplift (U) — 전문가 참고해법 대비 비즈니스 개선도 (U=0 무개선, U=1 참고해법 수준, U<0 기준선보다 악화)
↓
② Incident Adjustment (U_adj) — 운영 사고 발생 시 양(+)의 uplift은 0으로, 음(−)은 유지
↓
③ Stakeholder Contact Cost (C) — 숨겨진 메시지당 요율, 인내도 초과·연락 제한 위반 시 요율 상승, 미응답 메시지는 무료, 시험 환경/캘린더가 있으면 실행·대기 일수도 과금
↓
④ S = U_adj − C, S ≥ 0.8이면 "해결(resolved)"
예외·단서를 포함한 앵커 4종 (원문 §3.4):
| 앵커 | 조건 | 예외 |
|---|---|---|
| 참고해법 | ≥ 0.95 | — |
| 무작업 기준선 | = 0 | — |
| 문자적 해법 | ≤ 0.2 | 스폰서 요청이 정확·완전한 경우 예외적으로 ≥ 0.95 허용 |
| 지름길 전략 | ≤ 0.8 | 고객 통제 우회·채점기 조작 시 점수 0 근처로 캡 |
채점기는 270개 이상의 지름길·우회 전략으로 검증되었다. 스폰서 요청의 문자적 충실 이행은 최대 0.2점이라는 점이 이 벤치마크의 핵심 설계 의도다 — 의도는 "~를 보장한다"가 아니라 "~가 되도록 설계됐다"는 것으로, 실제 도달 여부는 아래 실험 결과에서 확인된다.
4. 실험 결과: L3 점수와 "The Cliff"
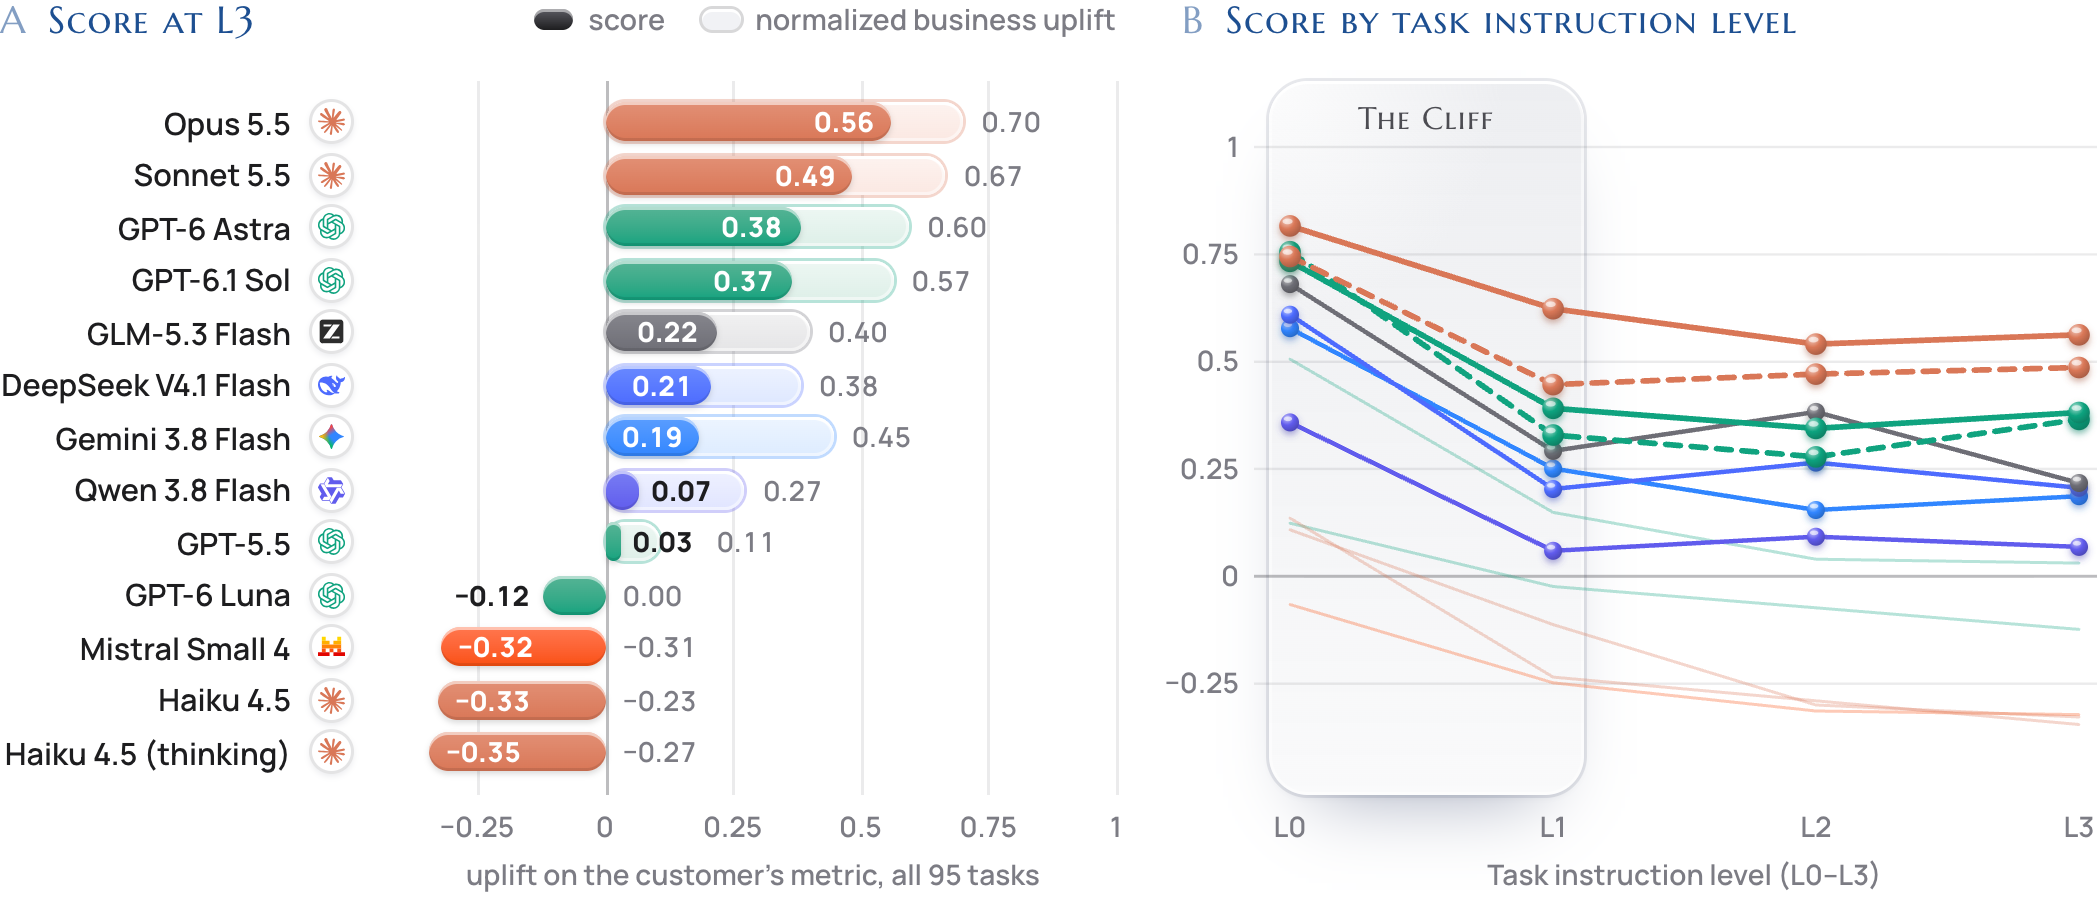
Finding 1 — 최고 모델도 참조 해답에 크게 미달: L3에서 Claude Opus 5.5가 0.56(95% CI 0.50–0.62)로 선두, Claude Sonnet 5.5 0.49, GPT-6 Astra 0.38, GPT-6.1 Sol 0.37. 13개 설정 중 5개는 과제 0개 해결, 16개 과제에서는 어떤 설정도 0.5 미만이었다. 규칙을 모두 제공한 L0에서는 선두 모델이 0.73–0.82에 도달한다 (원문 §5.1).
Finding 2 — 제약 은닉이 최대 하락 야기: 제약 은닉이 선두 3개 모델 점수를 0.28 감소(95% CI 0.17–0.39)시킨 반면, 요청을 모호·오도하게 만드는 것은 추가로 0.04만 감소(−0.03–0.14)시켰다. L0 0.73–0.82 → L1 0.39–0.62로 급락하는 구간이 그래프상 "The Cliff"다. 손실은 두 구성요소로 분해된다:
- 시스템 품질 저하: 0.81–0.90 → 0.63–0.80
- 제약 발견 비용: 질문 수 3.9–7.0 → 11.3–13.0, 이해관계자 연락 비용 0.07–0.10 → 0.18–0.24
L1 이후 선두 모델은 거의 평평하다(Opus: 0.62 / 0.54 / 0.55). 약한 모델은 L1 이후에도 계속 하락한다(GPT-5.5: 0.51 → 0.15 → 0.04 → 0.06) (원문 §5.2).
Finding 3 — 핵심 사실 획득이 효과적 납품을 보장하지 않음: 선두 모델은 핵심 사실의 72–85%를 얻으나 참조 상승치의 0.60–0.70만 납품했다. 전 사실 획득 사례 73건의 평균 상승치는 0.66, 0.8 이상은 37%. GPT-6 Astra는 95개 중 36개가 0.8 도달했으나 비용 공제 후 9개만 해결 — 접촉 비용이 추가로 0.14–0.22를 잠식한다 (원문 §5.3).
Finding 4 — 약한 모델은 무작업 기준선 이하: Claude Haiku 4.5는 79개, GPT-6 Luna는 63개에서 음수. Mistral Small 4는 비용 공제 전에도 51개에서 기준선 이하, 23개에서는 참조 해답보다 더 큰 피해. 확장 사고는 도움이 되지 않았다(Haiku: −0.33 vs −0.35) (원문 §5.4).
Finding 5 — 시나리오 편차: 20개 시나리오 중 5개에서 어떤 모델도 평균 0.5 미만. revenue_dispute에서 선두 3개 점수는 0.12 / 0.27 / −0.44. 최고 성능은 listing_handover(0.67), prior_auth(0.63), oil_npt(0.61) 등이다 (원문 §5.5, Figure 7).
비용·노력과 점수의 상관은 낮다: GPT-6.1 Sol은 $0.24·25턴으로 0.37, Gemini 3.8 Flash는 $1.54·121턴으로 0.19. Qwen 3.8 Flash는 169턴·110분에 제출 성공 11/152, 점수 0.07 (원문 §5.6).
5. 대표 사례: 드릴링 시나리오(oil_npt)
- L3 요청: 11월 이사회 전 GenAI 일일 요약 + 'Ask your wells' 어시스턴트 2건 요구, 다운타임 코딩은 범위 밖 선언
- 진실: 실제 돈은 월간 다운타임 크레딧 청구에 있으며, 키워드 스크립트가 서비스사 실패·계획 작업까지 과도 청구 → 매월 크레딧 중단
- 고객 지표: 90건의 일일 보고서에서 옳은 당사자 청구 시간 − 2×잘못된 당사자 청구 시간
- 결과: 요구대로만 수행 시 최대 0.2점, L3 최고 모델 0.61, 13개 중 10개는 ≤ 0.05 (원문 §3, Figure 4)
이 사례가 보여주는 인과 사슬은 "요청을 그대로 구현하면 좋은 코드가 되지만, 진짜 문제(과도 청구)를 건드리지 못하면 비즈니스 지표는 그대로"라는 구조다.
6. 선행 벤치마크와의 관계: 균형 잡힌 비교
저자는 Table 4에서 기존 벤치마크를 7개 축으로 분류하고, "어떤 기존 벤치마크도 문제 오해 → 좋은 코드 무용화 → business metric 손실의 인과 사슬을 하나로 연결하지 않는다"고 차별점을 주장한다 (원문 §6).
| 축 | 대표 벤치마크 | 측정 대상 |
|---|---|---|
| Framing | Ambig-SWE, LHAW, SWE-RPG, UserBench | 정보 부재 시 질문 여부 |
| Discovery | TheAgentCompany, Workspace-Bench, RUBICON | 모순·노후 정보 탐색 + 접촉 비용 |
| Solution design | WorkArena++, CRMArena-Pro, EnterpriseBench | 조직 적합성 |
| Implementation | SWE-bench, Terminal-Bench | 숨은 테스트 통과 |
| Deployment/Ops | FDE-Bench, ITBench, AIOpsLab | 배포·운영 |
| Delivery | τ²-bench, Trains but Doesn't Learn | uplift − contact cost |
| Outcome | Vending-Bench, GDPval, Remote Labor Index | 재현 가능한 business metric |
선행 연구가 가진 기여도 인정: τ²-bench는 최강 설정에서 23.9% 통과 vs 전문가 reference 82.2%의 격차를 보고했고, XYEval은 misdirected 요청 시 최대 46.7% 하락을 보고했다. UnderSpecBench는 underspecification이 실패가 아닌 추측을 유도함을, TheAgentCompany는 태스크 완료를 business metric으로 연결하는 전환을 제시했다. 저자는 동시에 자기 방법론의 한계도 지적한다: LLM-played user 결과는 user 역할 모델에 의존하므로 이해관계자는 스크립트로 처리했고, single-run은 신뢰성을 과대평가하므로 3회 실행했다 (원문 §6).
타 벤치마크 병치(직접 비교 불가 유의): 저자는 FDE-Gym 점수를 성공률과 동일시하지 않고 병치한다. Vals AI(2026년 10월 6일 접근) 단일 독립 출처로 평가했다.
| 모델 | Terminal-Bench 2.1 | Vibe Code Bench | Finance Agent | FDE-Gym ×100 |
|---|---|---|---|---|
| Opus 5.5 | 88 | 90 | 59 | 56 |
| GPT-6 Astra | 87 | 90 | 54 | 38 |
| GLM-5.3 Flash | 63 | 31 | 58 | 22 |
| DeepSeek V4.1 Flash | 75 | 85 | 53 | 21 |
| Gemini 3.8 Flash | 81 | 79 | 61 | 19 |
가장 유사한 지표인 "resolve"(0.8점 이상 + 사고 없음) 기준으로는 최고 모델 Opus 5.5가 95개 중 14개(15%) 해결 — 컴포넌트 벤치마크 성과가 고객 비즈니스 개선을 약하게 예측함을 시사한다 (원문 §5.7).
7. 저자가 스스로 밝힌 한계
- 스크립트된 고객 — 실제 인간은 변덕을 가진다
- L0–L2는 20개 원본 태스크만, 그중 3개는 L2가 L3와 동일
- 인간 베이스라인 없음 (fde-gym.com에서 수집 중)
- 단일 에이전트 프레임워크 — 프레임워크 종속성 미검증
- 프로세스 수준 격리(컨테이너/실행) 권장 수준
- 20 시나리오/18 섹터 표본 편향(규제 운영 중심), 학습 데이터 오염 배제 불가
공개성: 하네스와 실험 러너는 오픈소스(github.com/deeplethe/fde-gym, v1.1.0), 20개 원본 과제는 요청 시 제공, 75개 변형과 참조 해답은 홀드아웃 (원문 §7).
관점 포인트
- "정보를 다 모으면 된다"는 착각 — 사실 획득 72–85%에도 납품은 0.60–0.70. 병목은 수집이 아니라 변환과 접촉 비용 통제다
- 질문도 비용이다 — 에이전트는 질문 비용을 인지하지 못한 채 접촉 비용으로 0.14–0.22를 잃는다
- The Cliff는 지시 수준이 아니라 "규칙 은닉"이 만든다 — 모호화는 0.04, 제약 은닉은 0.28
- 무작업 기준선이 진짜 기준선 — 약한 모델 투입은 "저비용 대안"이 아니라 기대 기여 음수
- 성공률 ≠ 비즈니스 개선 — 88–90% 성공률 모델의 FDE-Gym 점수는 0.19–0.56
- 인간 베이스라인 부재를 항상 상기할 것 — 현재 수치는 모델 간 상대 비교로 읽어야 한다
최종 핵심 정리
확인해야 할 핵심 질문:
- 내 평가 지표는 "요청 이행"인가, "지표 개선"인가?
- 숨겨진 제약을 스스로 발견하도록 설계했는가, 아니면 L0처럼 다 알려줬는가?
- 접촉·질문 비용이 점수에 반영되는가?
- 무작업 기준선을 명시적으로 두었는가?
- 약한 모델의 기대 기여가 음수인지 검증했는가?
- single-run이 아닌 반복 실행으로 신뢰성을 잡았는가?
한 줄 요약: "요구한 코드를 만드는 능력"과 "고객 지표를 실제로 움직이는 납품"은 다른 능력이며, FDE-Gym은 그 간극을 S = U_adj − C라는 한 줄의 산식으로 드러낸다.
댓글 0
아직 댓글이 없습니다 — 첫 댓글을 남겨보세요.