RNN의 단기·장기 기억 병목, 두 개의 행렬로 나눠 풀었다 — Continuous Memory Machine 논문 해설
한 문장 요약: 이 글을 읽으면 Sakana AI가 제안한 순환 아키텍처 CMM(Continuous Memory Machine)이 단기 계산과 장기 보존을 어떻게 분리했고, 어떤 성립 조건·설정 아래에서 베이스라인을 상회했는지 이해할 수 있습니다.
개요
- 주제: NeurIPS 2026 PALM 워크숍 게재 논문 "Continuous Memory Machines" 해설
- 핵심 관점: 저자는 RNN의 병목을 "용량 확대"가 아니라 기억 저장소의 기능 분리로 풀었다고 주장한다
- 핵심 키워드: CMM, CTM, 단기기억(STM)·장기기억(LTM), Transformer 공동 갱신, sink 토큰, 어블레이션
핵심 메시지 3가지
1. 병목의 원인 — 하나의 벡터가 모든 것을 맡는다
저자에 따르면 RNN은 전체 시퀀스 역사를 단일 은닉 벡터로 압축하여, "단기 계산과 장기 보존이 동일 표현을 공유"하는 병목이 발생한다 [원문 p.1]. 기존 확장책도 근본을 못 건드렸다는 것이 저자의 진단이다.
- 다중스케일 RNN(Clockwork, Fast-Slow): 시간척도 분리에 그침
- Fast weight RNN(FWP, xLSTM, GDN): 단일 재귀 상태의 용량만 확대
- MANN(NTM, DNC, RMC): 외부 저장소는 있으나 컨트롤러 상태가 제한적
- Recurrent Transformer(Transformer-XL, RMT): 은닉 표현·메모리 토큰만 전달
"These approaches expand capacity or separate timescales, but the combination of persistent memory with rich short-term neural dynamics remains relatively unexplored." [원문 p.2]
2. 생물학적 동기 — 보완적 학습 시스템(CLS)
저자는 보완적 학습 시스템 프레임워크(해마=빠른 학습, 신피질=느린 보존)를 근거로, 단일 저장소로는 "새 정보를 인코딩하면서 축적된 지식을 간섭 없이 안정적으로 보존할 수 없다"고 논리한다 [원문 p.2]. CTM이 풍부한 단기 뉴런 역학은 보였지만 장기 저장이 없다는 점이 이 논문의 출발점이다.
3. 제안 — 두 개의 행렬값 저장소 + 공유 Transformer의 양방향 read–write
CMM은 CTM의 행렬값 단기기억(STM) A^t과 명시적 장기기억(LTM) B^t를 분리한다. 저자는 공유 Transformer가 "각 기억이 자체 내용을 재구성하면서 상호 읽기/쓰기가 가능한 양방향 메커니즘"을 제공한다고 주장한다 [원문 초록].
4. 아키텍처: 성립 조건과 데이터 흐름
CMM의 핵심 관계가 성립하려면 두 저장소가 기능적으로 독립이어야 하고, 갱신이 양방향이어야 한다. 저자가 설정한 1타임스텝 흐름은 다음과 같다 [원문 p.2, 그림 1].
| 단계 | 연산 | 유지/폐기 |
|---|---|---|
| ① 관찰 | o^t + 이전 활성상태 z^t → 시냅스 모델 → 활성화 전 상태 a^t | — |
| ② STM 갱신 | a^t를 슬라이딩 윈도우에 추가 → A^t 형성 | A^t는 롤링 윈도우로 유지 |
| ③ 시퀀스 결합 | X^t = [s; B^{t-1}; A^t] (싱크 토큰 + LTM + STM), 위치 임베딩 부여 | — |
| ④ Transformer | J개 블록 통과 → [s̃^t; B̃^t; Ã^t] | — |
| ⑤ 출력 생성 | Ã^t → 뉴런 수준 모델(NLM) → z^{t+1} | Ã^t는 z^{t+1} 생성 후 폐기 |
| ⑥ 상태 전달 | 동기화 S^{t+1}, 출력 y^{t+1} 산출 | B̃^t = B^{t+1}은 지속 유지 |
성립 조건 3가지:
- 독립 저장소 — STM은 최근 활성화 이력, LTM은 타임스탬프에 걸쳐 정보를 보존·재구성 (RMC와 달리 "기능이 다른 별도 단기·장기 행렬값 저장소"를 유지한다) [원문 p.3]
- 양방향 갱신 — 한 저장소가 다른 저장소를 읽고 쓸 수 있어야 공동 갱신이 성립
- 싱크 토큰의 value 투영 = 0 — 학습된 싱크 토큰 s는 "무의미한 어텐션 질량을 흡수하며, 두 저장소 중 하나로의 어텐션을 억제할 수 있어 유연한 기억 사용을 가능케 한다" [원문 p.3]
5. 저자가 실제 사용한 주요 설정 (예외·단서 포함)
일반형과 달리 저자가 실험에서 실제로 쓴 설정에는 중요한 예외가 있다. 요약 시 빠지면 재현이 불가능한 항목들이다 [원문 부록 A, D].
| 항목 | 저자의 실제 설정 | 예외·단서 |
|---|---|---|
| LTM 초기화 | B⁰ ~ 𝒩(0, 0.01²) | CTM과 달리 활성화 상태·STM은 0 버퍼 고정 |
| 위치 임베딩 | Q, K에만 부여 | V에는 부여하지 않음 — "내용은 변하지 않도록" |
| FFN | SiLU 기반 bias-free 구조 | — |
| 잔차 게이트 γ_j | 학습된 스칼라, 초기값 0 | Maze·Parity에서만 사용, 그 외 실험은 γ_j=1 고정 |
| 동기화 정규화 | CTM의 제곱근 나눗셈을 제거하고 선형 합으로 나눔 | "t에 불변한 정규화 이동평균" — 학습 시 보지 못한 thinking horizon 일반화 목적 |
| 메모리 용량·깊이 | Priority Sort: M_L ∈ {2,...,128} 증가가 성능 향상, J ∈ {2,4}가 최적 | 500K 파라미터 예산, M_S=5 제한 조건에서의 스윕 |
| 태스크별 하이퍼파라미터 | Copy: M_S=10, M_L=128, J=1, D=8 / Maze: M_S=10, M_L=8, J=1, D=16 | — |
| 최적화 | AdamW(lr 10⁻⁴), 스케줄러 없음 | ImageNet-100만 cosine annealing(25 에폭), weight decay는 기본 0 |
6. 실험 결과 — 숫자로 보는 성능
알고리즘 과제 [원문 p.5]
| 과제 | CMM | 비교 (CTM/기타) |
|---|---|---|
| Copy | 손실 5×10⁻² 미만 | CTM 3.1×10⁻¹ |
| Associative Recall | 정확도 99.95% (손실 10⁻³ 미만) | CTM 손실 3.2×10⁻² — "CMM의 60배 이상" |
| Priority Sort | 손실 4.1×10⁻³ (최저) | DNC 1.4×10⁻², Transformer 2.7×10⁻² |
| 길이 일반화 N=50 | 72.1% | RMT 68.2%, DNC 55.8% |
미로 해결 (39×39, 10M 파라미터) [원문 p.5, 표 1]
- 행동 정확도 96.3±3.8%, 전체 미로 정확도 61.6±35.0%
- CTM 대비 상회: CTM은 88.8% / 37.4%
- 최고 단일 런: 전체 미로 정확도 90.7%
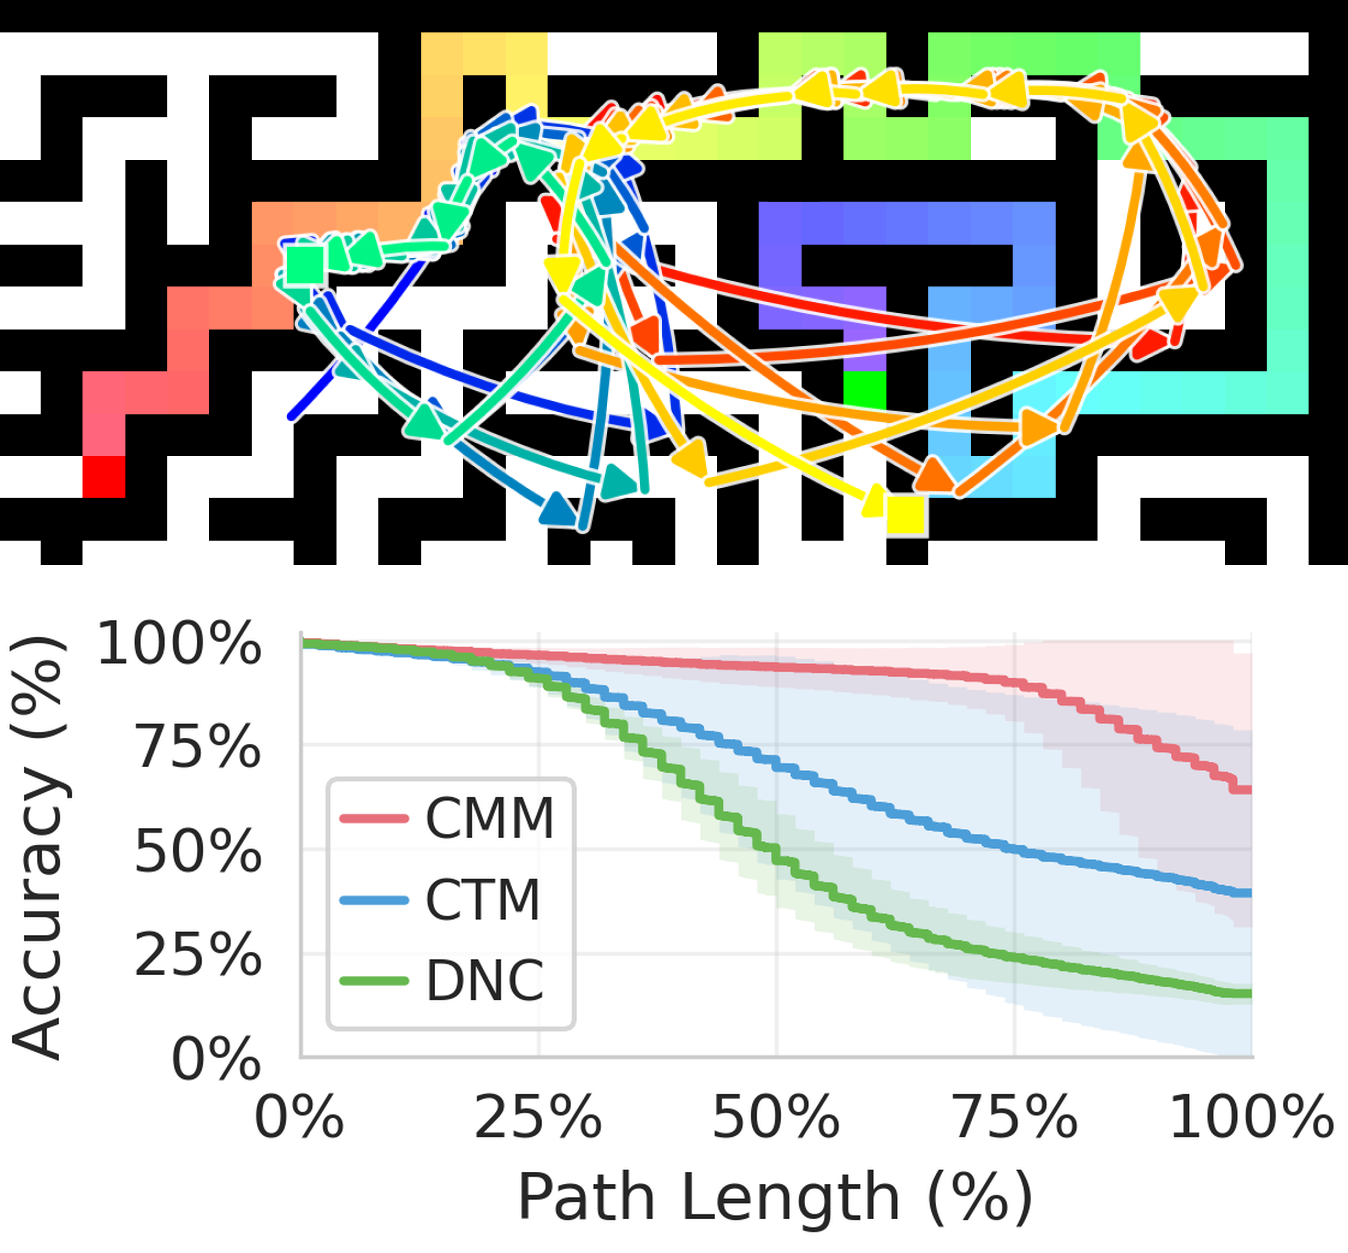
경로 길이가 길어져도 CMM의 정확도 하락이 가장 완만하다. 다만 시드별 상세(표 9)에서는 CMM이 3개 지표에서 97.90±71.28 / 91.93±22.84 / 99.08±90.73으로 평균은 높으나 표준편차가 매우 크다 — 실험 간 편차가 크다는 점은 결과 해석 시 반드시 함께 봐야 할 수치다.
Few-shot 회귀 (표 2) 및 ImageNet-100 (표 3) [원문 p.6]
| 모델 | K=20 | K=10 |
|---|---|---|
| CMM | 30.63±0.24 | 9.86±0.07 |
| RMT | 30.46 | 9.81 |
| LSAM | 29.82 | 8.99 |
| CTM | 8.78 | 4.85 |
| 어블레이션 CMM-LSTM | 19.95±8.75 | — |
| 어블레이션 CMM-STM | 13.03 | — |
ImageNet-100 정확도는 CMM 89.7±0.2%로 최상위권. 다만 GDN 63.3±41.3, LSAM 59.2±49.0, RMC 75.9±9.0은 높은 편차를 보여 불안정하다.
어블레이션의 함의: CMM-LSTM(19.95)·CMM-STM(13.03)의 현저한 저하는, 저자가 주장하는 "CTM의 뉴런 수준 분산 단기 표현"이 실제로 기여한다는 실험적 지지로 읽힌다.
어텐션 시각화 — 과제별로 다른 기억 전략 [원문 p.6, 그림 6]
- Copy: STM 쿼리가 LTM에 주로 어텐션
- Sort: 출력 시 STM이 자기 자신에 점차 어텐션
- 미로: STM 쿼리가 0값 sink에만 어텐션 → STM/LTM 읽기가 모두 억제됨. 저자는 이를 "CMM의 이득이 메모리 Transformer의 FFN 표현력에서 비롯됨을 시사"하는 것으로 해석한다
- ImageNet-100: 후반 반복에서 sink로 이동
즉 저자는 CMM이 메모리 집약 과제에서는 LTM에 의존하고, 불필요한 경우 우회하는 등 과제에 따라 다른 기억 전략을 학습한다고 주장한다.
7. 선행·후속 연구의 기여 균형
| 연구 계보 | 기여 | CMM과의 관계 |
|---|---|---|
| LSTM/GRU | 게이트 기반 장기 의존성 | CMM은 단일 벡터 대신 행렬값 이중 저장소로 대체 |
| Clockwork/Fast-Slow RNN | 시간척도 분리 | 속도 분리만으로는 뉴런 역학+지속 보존 결합에 미달 |
| Fast Weight Programmer, xLSTM, GDN | 행렬값 상태·용량 확대 | 단일 재귀 상태 용량 확대에 그침 |
| NTM, DNC | 구조화된 어드레싱 외부 기억 | CMM은 DNC의 구조화 어드레싱 대신 자기주의(self-attention) 채택 |
| RMC | 자기주의로 기억 슬롯 상호작용 학습 | CMM이 따르는 가장 가까운 선행 — 단, RMC와 달리 별도 단·장기 저장소 유지 |
| LSAM, NAM-TM | 외부 기억 + 컨트롤러 | few-shot에서 CMM에 근접(29.82, —)하나 상회당함 |
| Transformer-XL, RMT | 은닉/메모리 토큰 전달 | 길이 일반화 N=50에서 RMT 68.2% < CMM 72.1% |
| CTM | 뉴런 수준 단기 역학의 이점 입증 | CMM의 직접적 기반 — 단, "장기 지속 저장 메커니즘이 없다"는 한계를 어블레이션으로 지적 |
후속/동시 작업에 대한 균형: CMM은 CTM의 해석가능한 어텐션 패턴을 보존하면서 성능을 끌어올렸다는 점에서 CTM 계보의 확장에 해당한다. 다만 저자 스스로 인정한 한계도 분명하다 — LTM 크기 M_L·Transformer 깊이 J 등 추가 하이퍼파라미터로 인한 계산·메모리 비용 증가, 비선형 RNN 반복 특성상의 학습 병렬성 제한(GDN 등 선형 반복 대비), 매 스텝 Transformer 갱신 시 sink 토큰에만 어텐션해도 계산이 낭비된다는 점이다. 저자는 t스텝마다 1회 갱신 등 선택적 업데이트를 개선 방향으로 제시한다 [원문 p.7].
재현성: 코드 공개(github.com/SakanaAI/continuous-memory-machines), 단일 NVIDIA H100으로 재현 가능. 학습 시간은 Copy 6.9h, Maze 127.5h(9,000 에폭)로 가장 크다. 미완료 베이스라인도 있다 — RMT는 학습 불안정으로 미완료, LSAM·GDN은 메모리 초과로 Maze 제외, RMC seed 2는 그라디언트 스파이크 중단 [원문 부록 C, D].
관점 포인트 — 실무자가 짚어야 할 5가지
- 분리의 조건: 두 기억이 정말 독립적이려면 갱신 경로가 분리되어야 한다 — CMM은 싱크 토큰과 양방향 read–write로 이를 해결
- 설정 예외를 잊지 말 것: 잔차 게이트 γ_j는 Maze·Parity 한정 학습 설정이다 — 나머지 실험은 γ_j=1 고정
- 정규화 수정의 의도: 동기화 정규화에서 제곱근을 제거한 것은 단순 튜닝이 아니라 학습 horizon 일반화를 위한 설계 변경
- 편차를 함께 읽기: 미로 결과의 높은 평균(61.6±35.0)과 표준편차(±71.28 등)는 함께 봐야 한다
- 어블레이션이 진짜 증거: CMM-LSTM·CMM-STM의 급락이 "뉴런 수준 단기 표현" 가설을 뒷받침하는 핵심 실험
최종 핵심 정리
확인해야 할 핵심 질문:
- 단기·장기 기억을 분리했는가? — 예, 행렬값 STM A^t와 LTM B^t로 명시적 분리
- 두 기억은 어떻게 상호작용하는가? — J개 Transformer 블록의 양방향 read–write, 싱크 토큰 s가 어텐션 억제 조절
- 저자가 실제 쓴 설정은? — B⁰ ~ 𝒩(0, 0.01²), 위치임베딩 Q/K 한정, 잔차 게이트는 Maze·Parity만, 동기화 정규화 제곱근 제거
- 성능은? — Recall 99.95%, 미로 행동 정확도 96.3±3.8%, few-shot K=20에서 30.63±0.24, ImageNet-100 89.7±0.2%
- 남은 한계는? — 추가 하이퍼파라미터 비용, 학습 병렬성 제한, 매 스텝 갱신의 계산 낭비, 미로 시드 간 편차
한 줄 요약: CMM은 "용량을 키우는" 대신 "기억을 나누고 양방향으로 연결"했더니, CTM의 뉴런 역학과 MANN의 지속 보존이 한 모델에서 동시에 작동했다는 것 — 단, 그 대가는 추가 하이퍼파라미터와 시드 간 편차라는 것이 저자 자신이 인정한 그림이다.
댓글 0
아직 댓글이 없습니다 — 첫 댓글을 남겨보세요.