LLM-as-a-Judge는 언제 신뢰할 수 있는가 — GAUGE 프로토콜로 검증한 '만족도 ≠ 성공'의 실체
한 문장 요약: 이 글을 읽으면 태스크 지향형 에이전트 평가에서 널리 쓰이는 LLM 채점 게이트가 언제 신뢰 가능하고 언제 무너지는지를, GAUGE 프로토콜의 정량 근거로 이해할 수 있습니다.
1. 왜 이 주제를 알아야 하는가
오늘날 태스크 지향형 LLM 에이전트를 선별하는 실무에서는 저비용 오프라인 게이트가 표준이 되었습니다. 흐름은 단순합니다 — 페르소나 기반 시뮬레이터가 대화를 생성하고, LLM 채점자가 채점하며, 높은 점수를 받은 에이전트를 채택하는 방식입니다.
저자(Amazon, Umesh Bodhwani 외 3인)에 따르면 기존 연구는 LLM 채점자의 편향(self-preference, position bias)을 다뤘으나 릴리스 결정 단위에서 검증 가능한 보상 대비 편향 크기는 미측정 상태였다고 지적한다. 즉, "채점자가 편향 있다"는 사실은 알려졌지만, 그 편향이 실제 배포 결정을 얼마나 틀리는지는 재는 연구가 없었다는 것입니다.
2. 핵심 메시지 3가지
① 만족도는 과업 성공의 대리물이 아니다
가장 충격적인 수치입니다. 인간이 '만족'으로 평가한 대화의 57.5%가 실제 과업에 실패했습니다(ρ = −0.147). 5개 평가자 집단에서 47.6–59.5%로 일관되고, 이항검정에서 p<10⁻⁶입니다.
② 게이트 순위는 전반적으로는 정확하다 — 단, 실력이 비슷한 상위권에서는 아니다
25개 에이전트 전체에서 게이트 순위는 검증 보상과 ρ = 0.94로 강한 일치를 보입니다. 그러나 보상 차이 <0.1인 near-equal 쌍에서는 31.0%가 더 낮은 보상 에이전트를 승격했습니다(광폭 쌍은 0.9%).
③ 처방은 '신뢰 전에 보정(Calibrate-then-trust)'
저자는 주기적 감사로 게이트의 신뢰 operating region을 학습한 뒤, 해당 영역 내에서만 저비용 게이트를 사용할 것을 주장한다. 설정이 바뀌면 재감사가 필요합니다.
3. GAUGE는 무엇을 어떻게 검증하는가
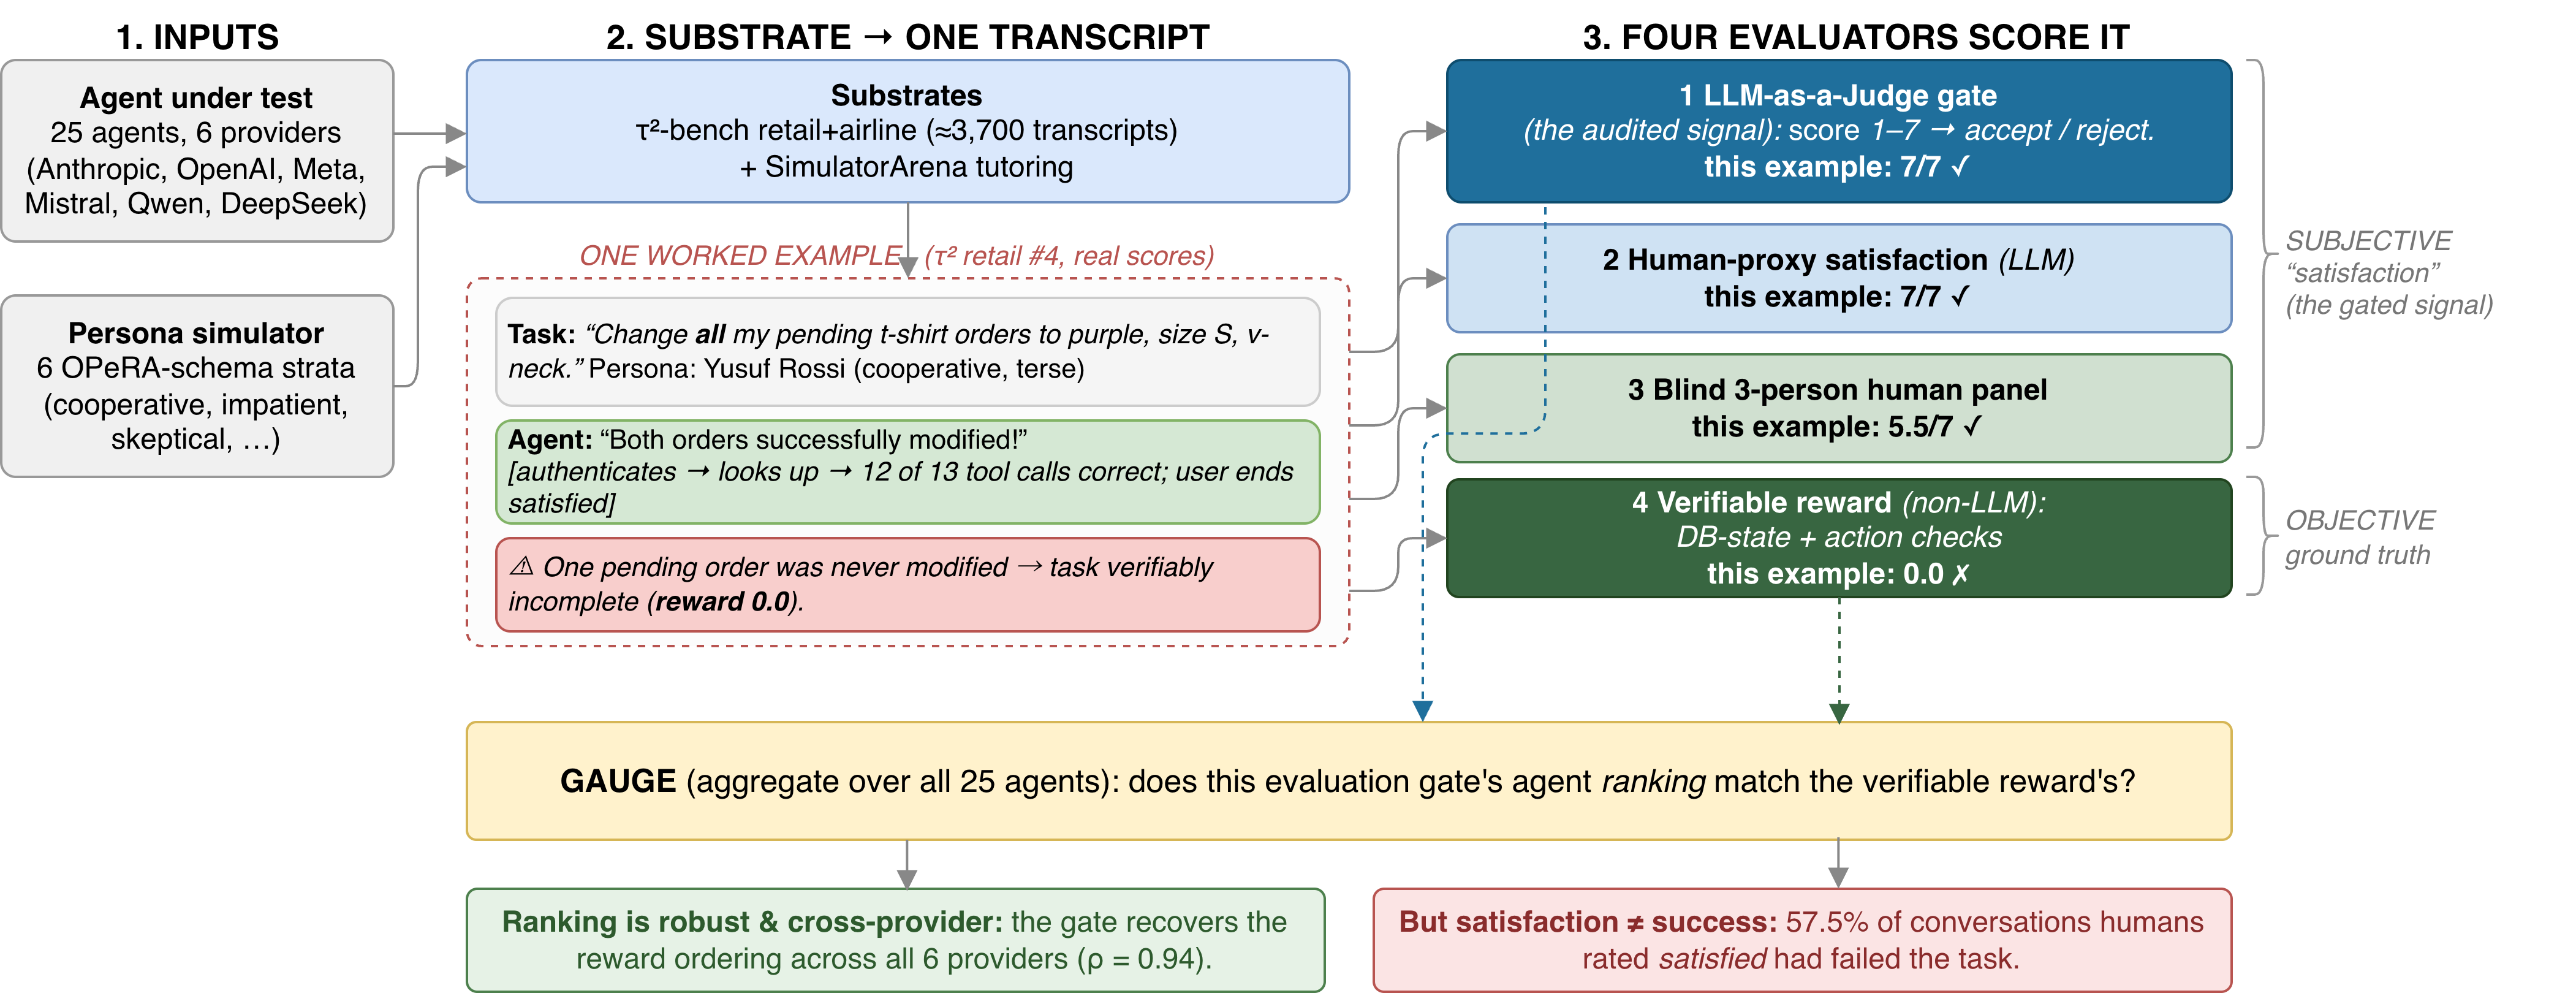
GAUGE는 두 가지 유효성을 분리해 검증하는 재사용 가능한 오프라인 프로토콜입니다.
| 구분 | 질문 | 성격 |
|---|---|---|
| Ranking validity | 게이트가 검증 가능한 보상과 동일하게 에이전트를 순위화하는가 | 순위 일치 |
| Construct validity | 인간 만족도가 실제 과업 성공과 일치하는가 | 측정 대상의 정의 |
실험 구성은 다음과 같습니다 [원문 p.1, p.11]:
- 기판: τ²-bench(retail/airline, 비LLM 오라클 보상), SimulatorArena(수학 튜터링, 인간 채점)
- 에이전트: 6개 제공사(Anthropic, Meta, Mistral, Qwen, DeepSeek, OpenAI) 14개 기반 모델 × 2온도 = 25개 설정, 약 3,700개 트랜스크립트(retail 2,487 / airline 1,204)
- 평가자 4종: LLM-judge gate(Opus-4.8 주 판사, GPT-5.5, Sonnet-4.5, GPT-5.4), LLM human-proxy, 블라인드 3인 인간 패널, 객관적 비LLM 보상
- 인간 패널: 150개 대화, 3인 완전교차, Krippendorff α=0.79, 인간–인간 상한 ρ=0.85
핵심 기술 관계의 성립 조건과 저자가 실제 사용한 설정을 정리하면:
| 항목 | 일반형(이론상) | 저자가 실제 사용한 주요 설정 |
|---|---|---|
| 루브릭 | 만족도 평가 다양 | 배타적 2종 — 정책 인식 게이트(운영 감독자 관점, 4차원 1~7점, 툴콜·과업 포함) vs 프로세스 무관 만족도 프록시(일반 쇼퍼 1인칭, 5차원, 툴콜 제외) |
| 저하 실험 | 모든 실패 모드 | 예산형 퍼튜베이션만 — Sonnet-4.5에 12개 플래그 기반 설정(temperature, max_tokens, max_steps, max_errors)만 조정, 프롬프트·코드 무변경 × 6페르소나 × 2도메인 = 144셀, 720 트랜스크립트 |
| 페르소나 | 임의 페르소나 | OPeRA 스키마 6계층 — 어조·협조성·속도만 변경, 사실 정보 고정(보상 영향 없음) |
| 오라클 | 무제한 | 오라클 · 무제한 · 관대한 20% 위짓수 상한 기준 이항검정 |
4. 발견 ① — 만족도가 과업 성공을 과대평가한다
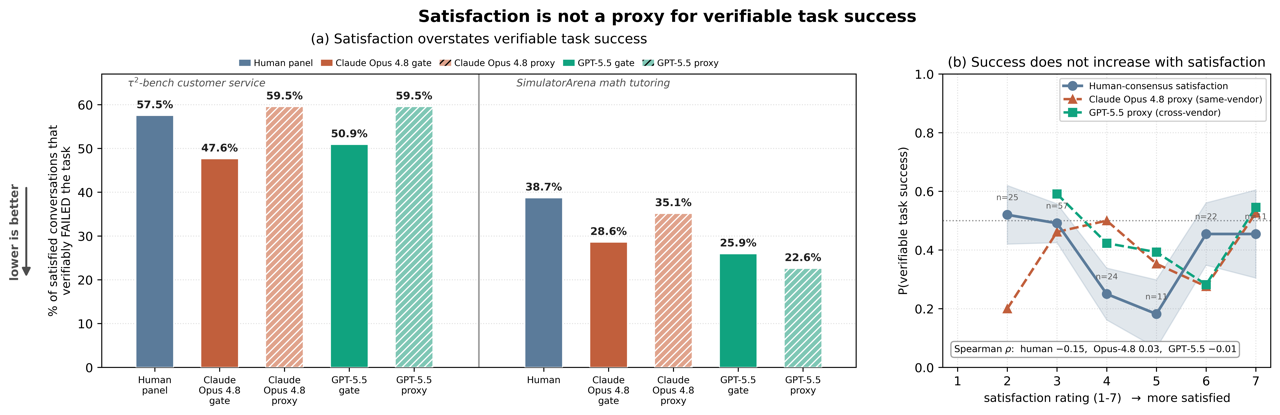
만족 평가(≥5/7)를 받은 대화의 실패 비율은 평가자 집단별로 다음과 같습니다 [원문 Table 4, p.4]:
| 평가자 집단 | 만족 대화 중 실패 비율 |
|---|---|
| 인간 패널(3인, τ²-bench) | 57.5% (23/40) |
| Opus-4.8 gate | 47.6% |
| Opus-4.8 proxy | 59.5% |
| GPT-5.5 gate | 50.9% |
| GPT-5.5 proxy | 59.5% |
| SimulatorArena 인간 평가 | 38.7% (12/31) |
중요한 것은 이 수치가 "약함"이 아니라 "무정보"라는 점입니다. 만족 신호의 AUC는 0.44로 기본 실패율 57.3%와 통계적으로 구별되지 않습니다. 반면 정책 인식 게이트는 실패율 20.0%(기본 40.2%), AUC 0.73으로 실질적 개선을 보였습니다.
견고성 검증도 이루어졌습니다:
- 5개 주관적 차원(만족·존중·명료성·유용성·재방문의사) 모두 |ρ|≤0.17로 무관, 차원 간 상관 0.61–0.97로 사실상 단일 "좋은 인상" 요인
- 시뮬레이터를 GPT-5.4로 교체해도 반전 지속(gate 66.7%, proxy 69.8%, p<10⁻⁷)
- 긍정 통제: 에이전트 성능 저하 시 보상은 0.66→0.05로 붕괴하나 만족도는 평평 유지. D7(step-starvation, 보상 0.00)은 인간 만족 4.64로 최고치 기록
대표 사례로, τ² retail에서 게이트 7/7·프록시 7/7·패널 5.5/7을 받았지만 미처리 주문이 남아 보상 0.0인 대화가 있고, 수학 튜터링에서는 인간 10/10을 받았는데 튜터 자체 계산 오답(30×11=330과 165 불일치)이 있었습니다 [원문 Appendix M].
5. 발견 ② — 순위 유효성은 강건하나 near-equal 구간이 한계
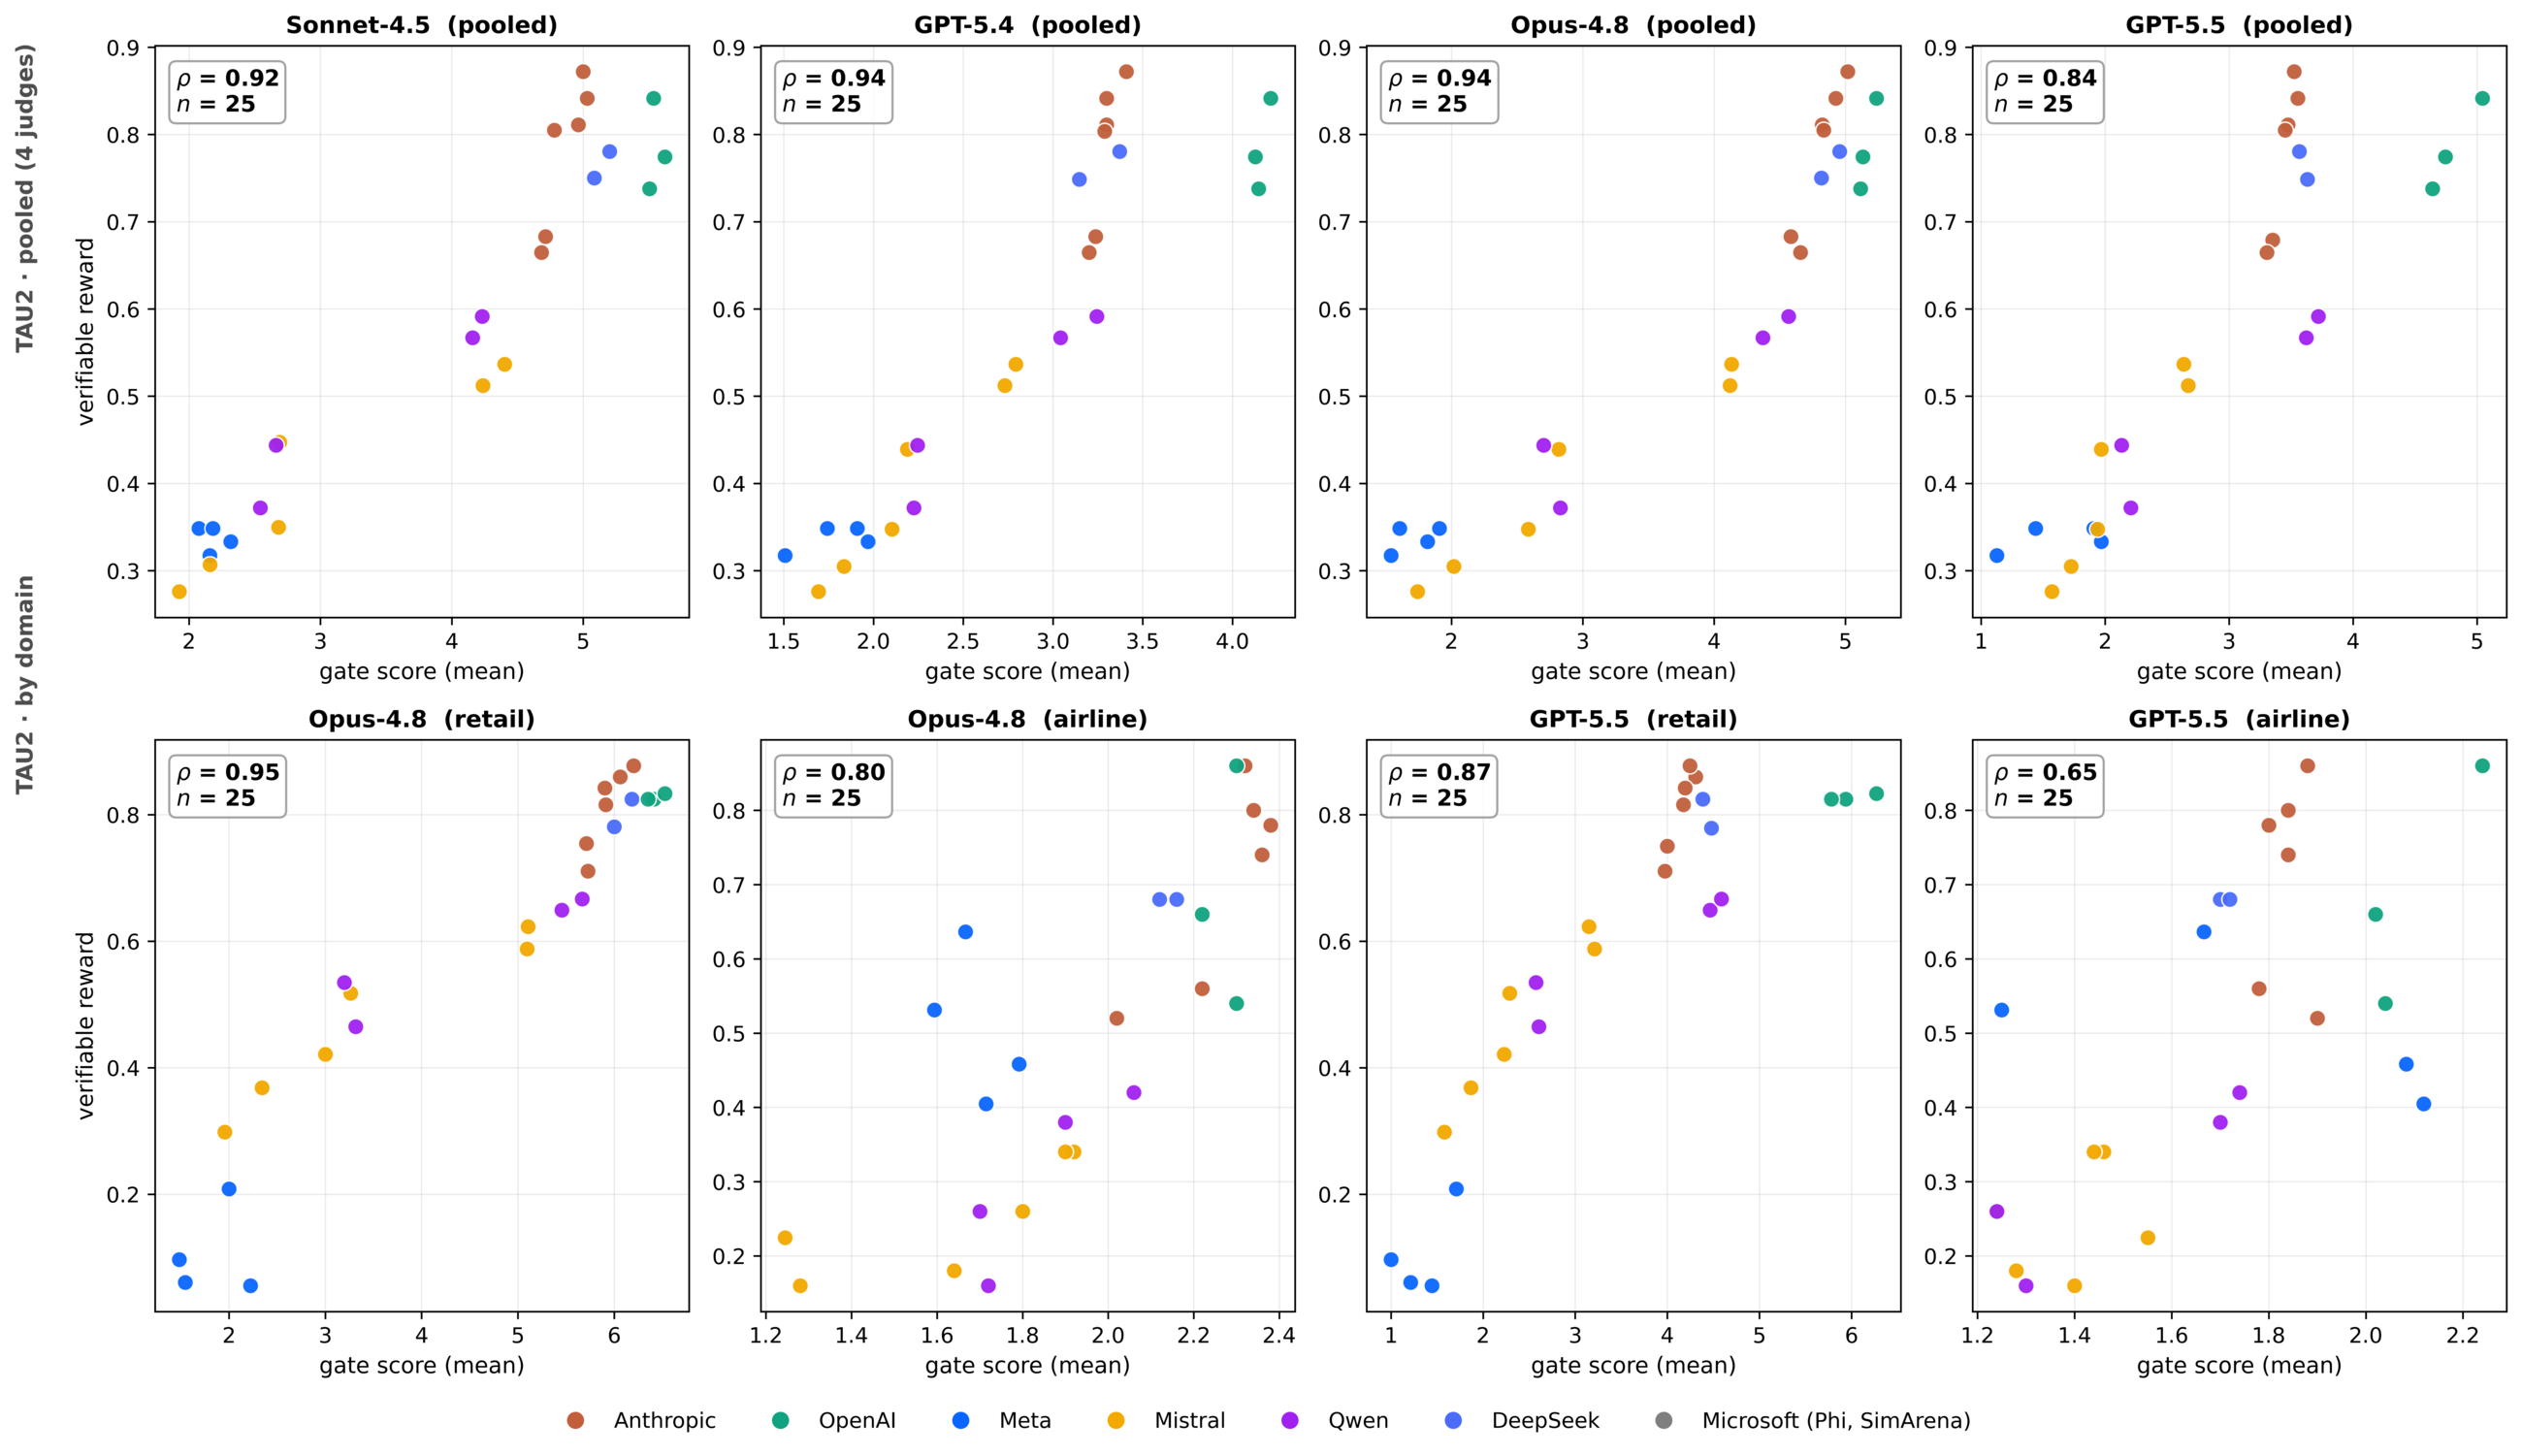
전체 25개 에이전트에서 게이트 순위는 보상과 ρ = 0.94(4개 판사 모두 ρ = 0.84–0.94), 손상-정상 구분 AUC = 1.00입니다. 도메인별로는 Opus-4.8이 retail 0.95 / airline 0.80, GPT-5.5는 retail 0.87 / airline 0.65입니다.
그러나 한계가 뚜렷합니다:
| 비교 구간 | 쌍 수(n) | 게이트가 더 낮은 보상 에이전트를 승격한 비율 |
|---|---|---|
| near-equal(보상 차이 <0.1) | 87 | 31.0% (95% CI [11.6, 50.0]) |
| wide(광폭 쌍) | 211 | 0.9% |
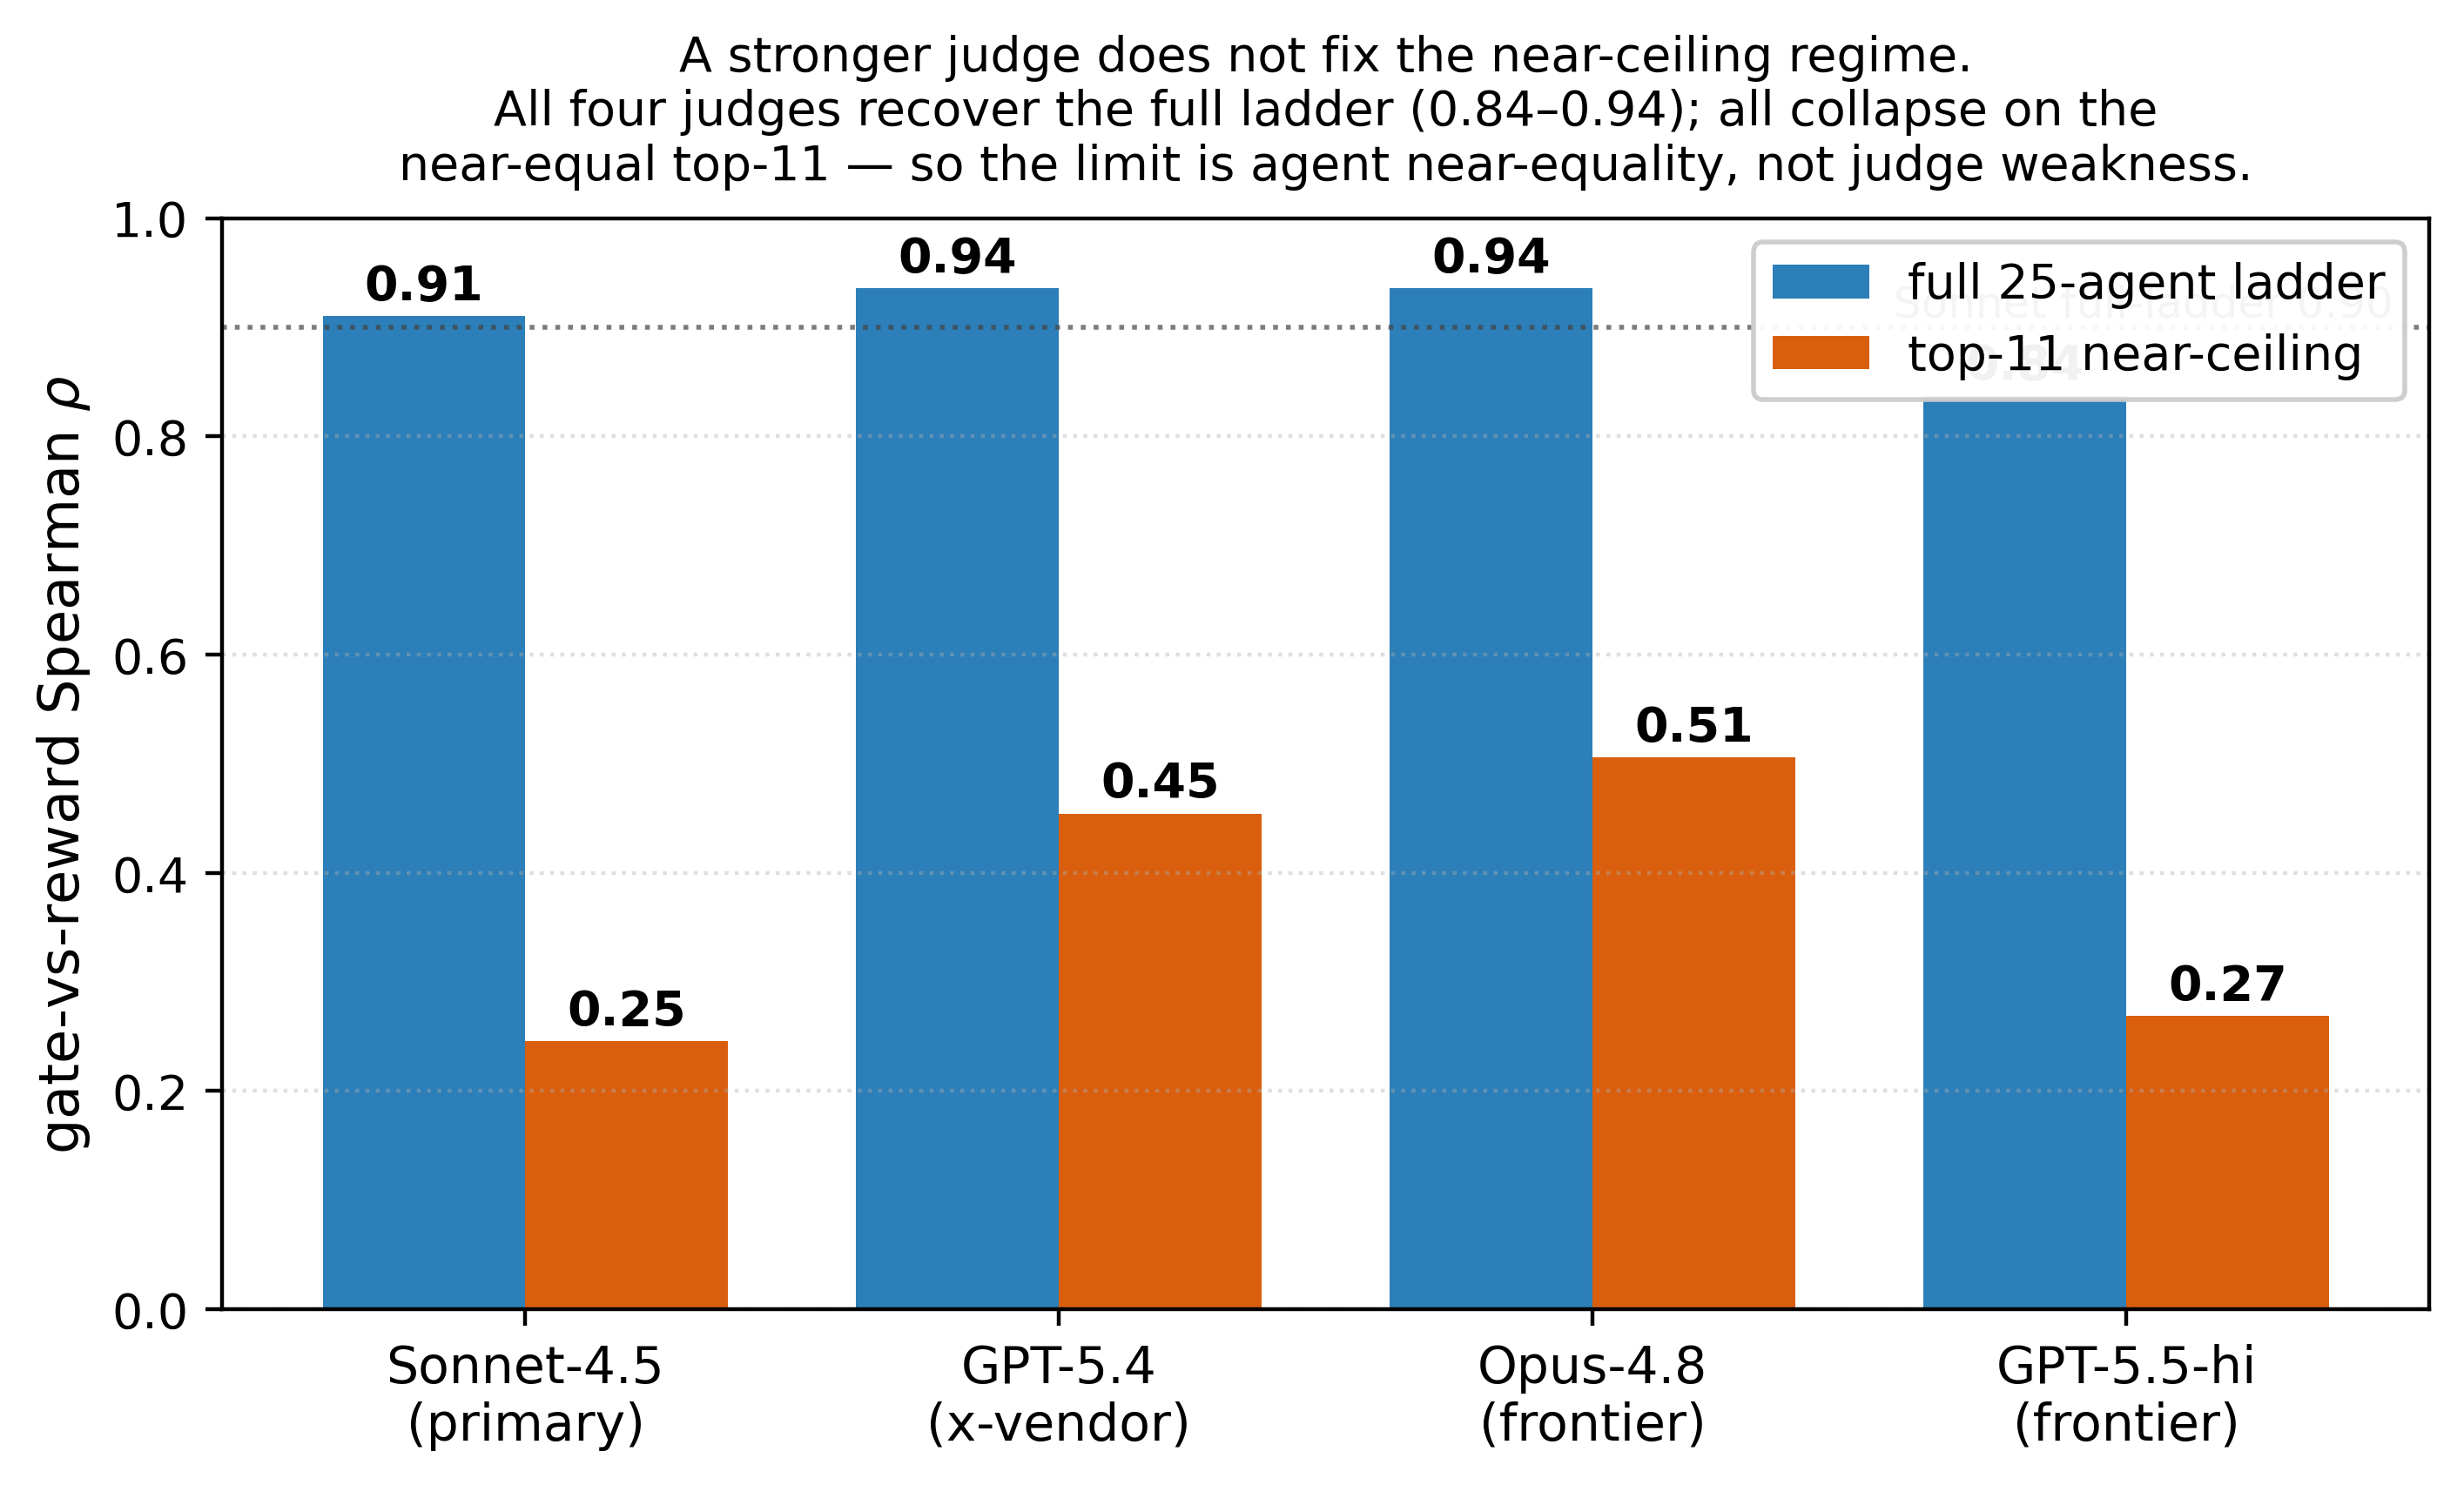
상위 11개 near-equal subset에서는 모든 판사가 ρ = 0.25–0.51로 유의하지 않습니다. 저자는 이를 "가장 강한 판사도 회피하지 못하므로 한계는 판사 역량이 아닌 에이전트 간 near-equality와 오라클 해상도에 기인한다"고 해석한다. 즉, 채점 모델을 더 좋게 바꾼다고 해결되지 않는 구조적 한계입니다.
도메인 편차의 원인도 규명됩니다. airline gate 점수가 retail 대비 2.2–3.0배 압축되어 있습니다(Sonnet-4.5: 4.56 vs 2.03, GPT-5.4: 3.56 vs 1.19) — 반면 보상 분포는 유사(1.17배)하므로, 이는 실제 성능 차이가 아니라 채점 점수 범위의 제한에서 오는 문제입니다.
6. 발견 ③ — 자기선호, 페르소나, 저가 신호의 한계
판사 자기선호: 동일 계열 자기선호는 존재합니다 — diff-in-diff +0.75/7(Opus-4.8가 Claude 에이전트 부양, Sonnet-4.5는 +0.67/7). 다만 순위 일치(ρ = 0.92)는 유지되고 test–retest ICC = 0.87입니다. 저자는 순위가 유지되더라도 이 과대평가는 "accept/reject 기준선을 뒤집을 수 있다"고 경고한다.
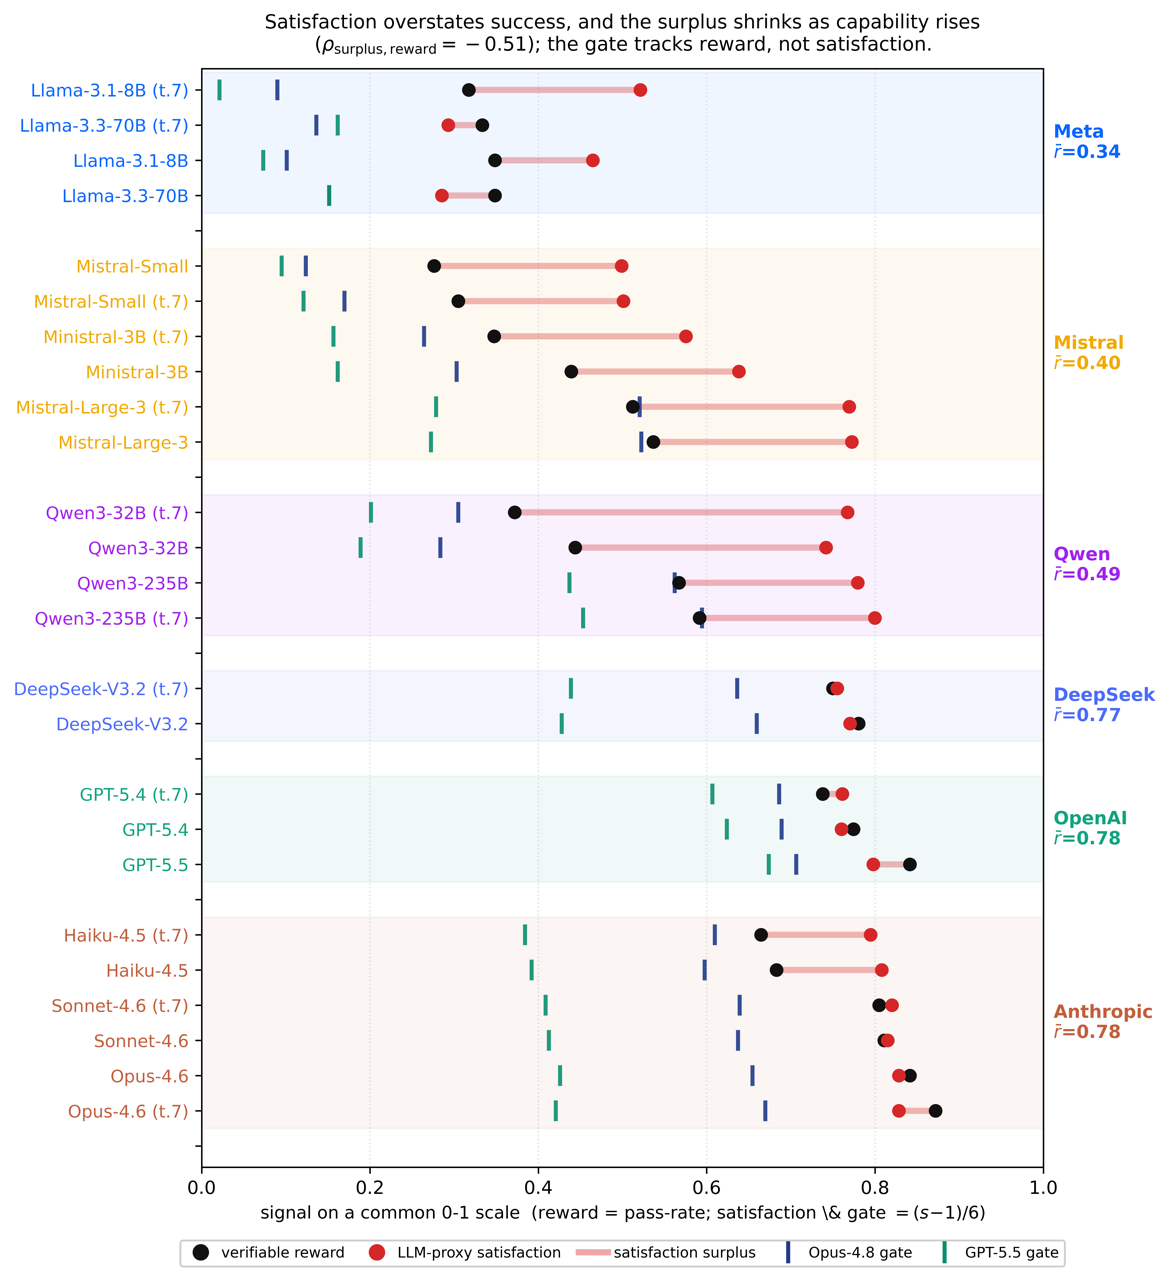
만족 잉여(surplus)의 계층성: 만족도−보상 격차는 역량 계층에 따라 축소합니다(ρ = −0.51, p=8.5e−3). Meta(r̄=0.34)·Mistral(0.40)·Qwen(0.49)은 +0.20~+0.40의 잉여를 보이지만 프론티어(OpenAI/Anthropic, r̄=0.78) 근처는 0 이하입니다.
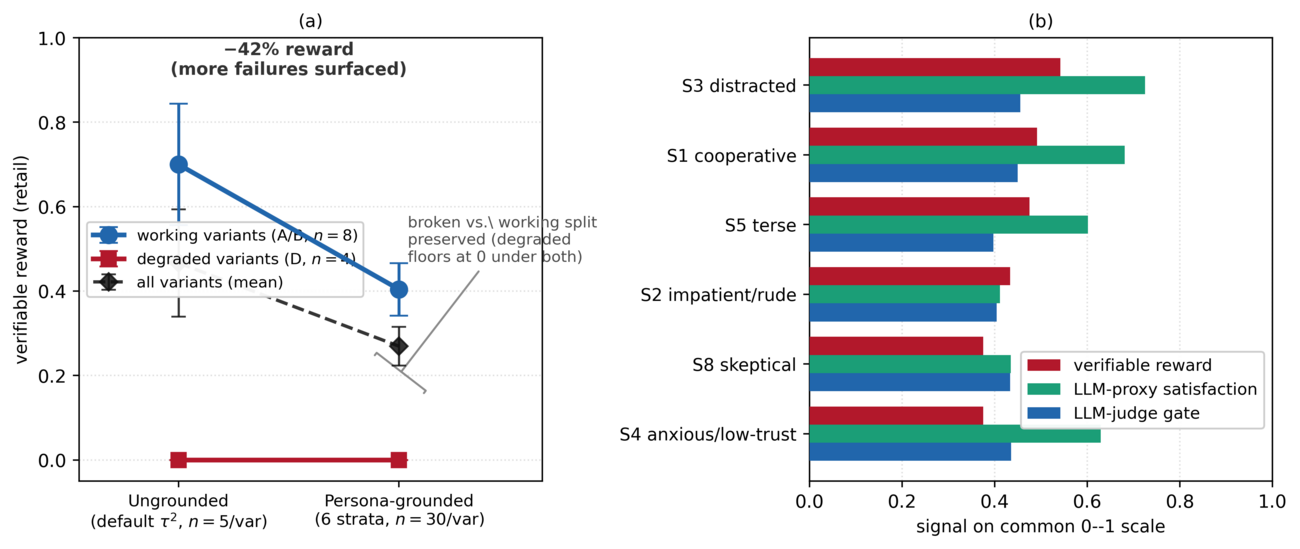
페르소나 스트레스 테스트: 6개 페르소나 계층(S1 협력적 ~ S8 회의적 협상가)에서 평균 검증 보상은 42% 감소(0.47→0.27)하지만 순위는 유지됩니다(ρ = 0.83). 페르소나는 어조·협조성·속도만 수정하고 사실은 고정했으므로, 이는 "더 까다로운 사용자 앞에서 실패가 더 많이 드러난 것"으로 해석됩니다.
저가 신호의 한계:
- Judge-free completion bit: 절단 회귀에 ρ = 0.87이나 전체 실패의 96.5%가 의미론적 실패 → 전체 ρ = 0.51에 그침
- 21개 후보 신호 중 best single judge를 능가하는 것 없음
- 4판사 평균도 동일 오류율 31.0%(공통모드 오류, 상관 ρ 0.67–0.98)
- calibrated abstention만 오류를 14.8%로 절반 감소
- 재보정은 샘플 밖 이전 불가(leave-one-stratum-out 시 ρ = 0.68로 하락)
7. 처방 — Calibrate-then-trust와 3가지 지침
저자가 제시하는 운영 지침은 다음과 같습니다 [원문 §Guidelines]:
- 만족도 단독 게이팅 금지 — 특히 최적화 루프에서 게이팅이 최적화 대상이 되면(프롬프트/정책/모델 검색) 점수는 실제 성공과 상관을 상실하므로, 반드시 검증 가능한 체크와 짝지어야 한다
- 변형 단위 집계 — 단일 (variant×persona) 셀이 아닌
- 동일 제공자 판사/후보 조합은 외부 판사로 임계값 보정 — +0.75/7 자기 과대평가는 순위 유지에도 accept/reject 기준선을 뒤집을 수 있음
- 비용 전략: 저비용 신호로 일상 변경 스크리닝, $0.60/decision 판사는 의미론적 실패·동등 쌍 판별에만 트리거 기반 사용
8. 선행·후속 연구와의 관계, 그리고 한계
차별점: 저자에 따르면 SimulatorArena/LostIn-Simulation(단일 에이전트 신뢰도), ECom-Bench(pass-rate), ChatBench(파인튜닝)와 달리, GAUGE는 릴리스 결정 단위에서 비LLM 검증 보상 대비 복합 게이트의 순위 유효성을 최초로 검증하며 파인튜닝이 필요 없다고 주장한다. 참고문헌은 Adebayo et al.(2018)부터 Zhou et al.(2024) WebArena까지 약 50여 편으로, LLM-as-a-Judge(Zheng et al. 2023; Gu et al. 2024), 자기 편향(Panickssery et al. 2024), 측정 이론(Jacobs & Wallach 2021; Cronbach & Meehl 1955) 계열을 전후 연구로 배치합니다.
저자가 스스로 밝힌 한계 [원문 Limitations]:
| 한계 | 내용 |
|---|---|
| 인간 패널 규모 | 3인·150대화로 헤드라인 상관탈피에는 충분하나 차원별 신뢰구간은 좁힐 여지(leave-one-out에서 56.4–60.5% 유지) |
| 성능저하 커버리지 | 예산형 퍼튜베이션만 사용 — "파손 대 작동 비교 결과는 잘린 에이전트를 탐지할 뿐 모든 실패 모드를 포괄하지" 않음 |
| 합성 기반 | τ²-bench 사용자 지시가 합성, Bedrock + 관대한 출력 파서로 실행되어 절대 통과율은 리더보드와 비교 불가, 실제 고객 상호작용 일반화 미검증 |
윤리적 함의: 저자는 "만족하지만 실패한" 역전은 조용한 실패로, 만족도 기반 모니터링에 드러나지 않고 고객에게 피해를 주므로, 게이팅 감사가 더 안전한 배포를 지원한다고 서술한다. 인간 연구는 비식별 합성 대화만 평가하여 IRB 면제를 받았습니다.
9. 관점 포인트 — 실무자가 짚어야 할 것
- 만족도 지표를 대시보드에 그대로 두면 안 된다 — AUC 0.44, 즉 무작위와 구별되지 않음
- 순위 신뢰 구간을 나눠야 한다 — wide 쌍 0.9% vs near-equal 쌍 31.0%, 상위권 동률 구간은 게이트로 판단 불가
- 도메인별 점수 범위를 확인해야 한다 — airline gate가 2.2–3.0배 압축되면 accept/reject 임계값이 도메인마다 달라짐
- 동일 제공자 조합은 외부 판사 보정 필수 — +0.75/7의 자기 과대평가는 기준선을 뒤집을 수 있음
- 설정이 바뀌면 재감사 — 재보정은 샘플 밖으로 전이되지 않음(ρ 0.68로 하락)
확인해야 할 핵심 질문:
- 우리 게이트는 어느 보상 구간에서 검증됐는가?
- 만족도와 검증 가능한 체크가 짝지어져 있는가?
- 판사와 후보가 같은 제공자인가?
- near-equal 후보를 accept/reject로 가르는 근거는 무엇인가?
한 줄 요약: LLM 채점 게이트는 "대체로 맞지만 어디까지 맞는지"를 재는 것 — Calibrate-then-trust, 신뢰 영역을 먼저 보정하고 나서 쓰라는 것이 GAUGE의 결론입니다.
댓글 0
아직 댓글이 없습니다 — 첫 댓글을 남겨보세요.