토큰을 아낀다고 해서 에이전트가 빨라지는가 — LLM 컨텍스트 압축 정책 65개 실험에서 나온 결론
[미디어: https://arxiv.org/abs/2609.32961]
한 문장 요약: 이 글을 읽으면 "컨텍스트 압축 = 토큰 절약"이라는 통념이 왜 실험에서 깨졌는지, 그리고 압축 정책을 무엇부터 설계해야 하는지 이해할 수 있습니다.
개요
- 주제: 논문 Beyond Token Savings: A Systematic Study of Context Compression in LLM Agents의 압축 정책 분석
- 핵심 관점: 압축은 토큰 수치가 아니라 에이전트 실행(성공률·지연·비용·과제 커버리지)으로 평가해야 한다는 저자의 주장
- 핵심 키워드: 컨텍스트 압축, Primitive/Trigger/Depth, TRC, 요약(SU/SS), 모델 전이성
핵심 메시지 3가지
1. 토큰 절감은 확실하지만, 그 절감이 곧 비용·지연 절감은 아니다
저자는 "적은 토큰이 반드시 더 빠르거나 더 저렴한 실행을 의미하지 않는다"고 주장한다. 실제로 Terminal-Bench + Qwen 조건에서 토큰을 약 1/3 수준으로 줄인 정책이 압축 미적용 에이전트보다 20–80% 느릴 수 있다고 보고한다 [원문 p.1]. 원인은 두 가지다 — 요약 재작성이 prefix 캐시를 무효화해 신규 요금이 붙고, 스텝 트리거 정책은 모델 호출 수를 10–27% 늘린다.
2. 같은 성공률이라도 해결하는 과제가 다르다
전체 resolve rate이 비슷해 보여도, 압축 정책은 FC(압축 미적용 기준선)가 해결한 과제 중 6–14개를 상실하는 대신 FC가 놓친 과제 중 2–7개를 새로 푼다. 저자는 "전체 성공률의 유사성이 과제 커버리지의 보존을 의미하지 않는다"고 주장한다.
3. 한 모델에서 찾은 최적 정책이 다른 모델로 그대로 이어지지는 않는다
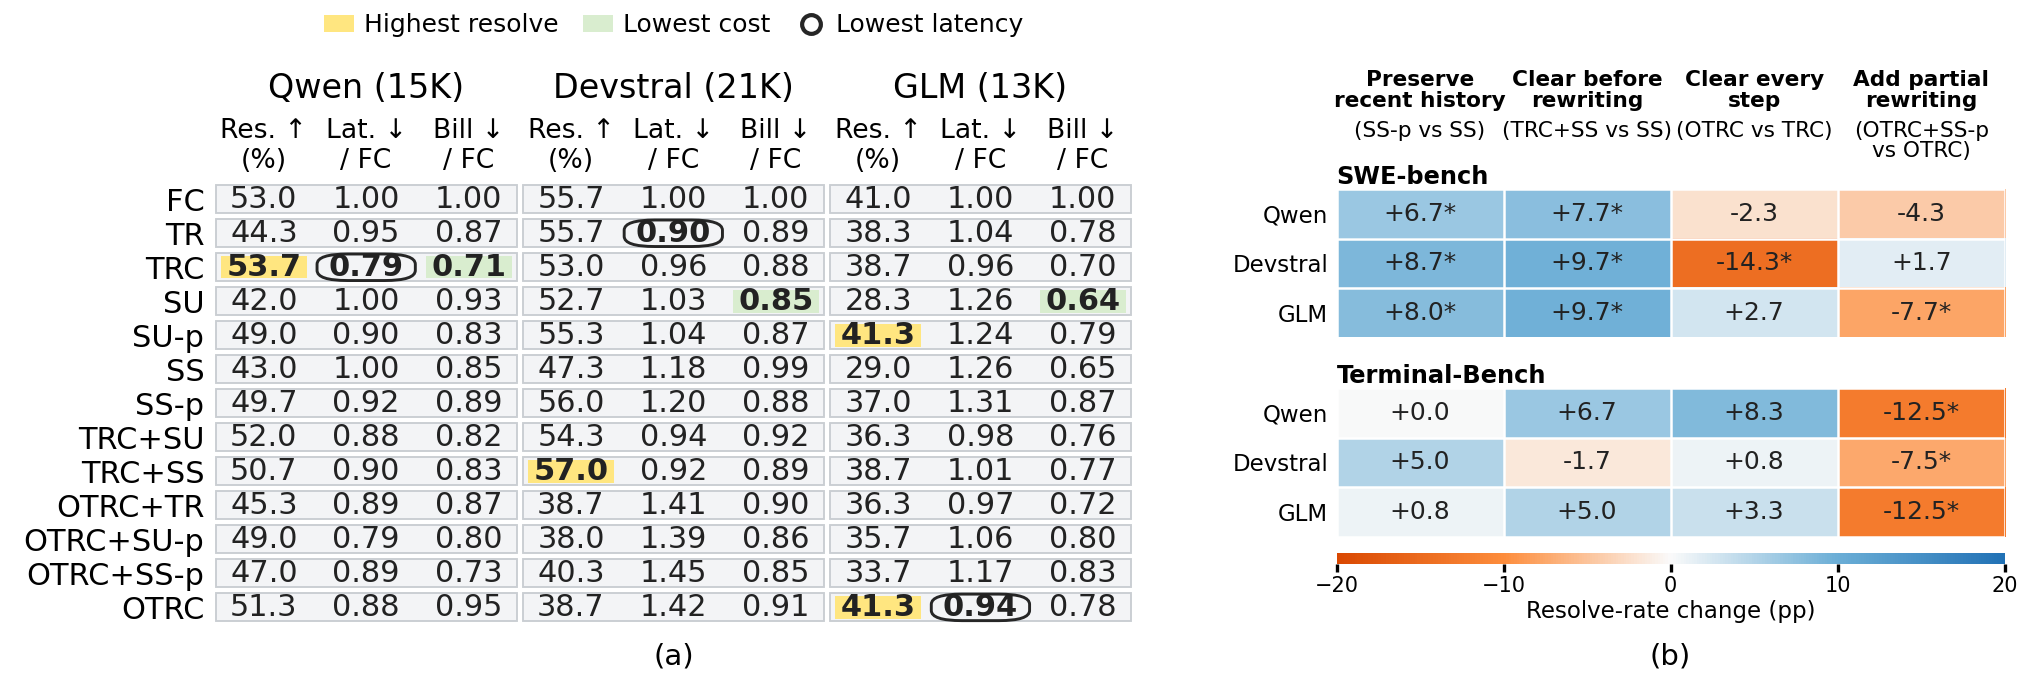
동일한 OTRC 정책이 Qwen에서는 51.3%, GLM에서는 41.3%로 우수했으나 Devstral에서는 38.7%·지연 1.42×로 급락한다. 다만 최근 이력 보존과 요약 전 도구 출력 정리라는 두 설계 선택은 3개 모델 모두에서 개선을 보여, 저자는 "재사용 가능한 정책 구성요소와 모델·워크로드별 적응을 결합할 여지가 있다"고 본다.
4. 왜 지금 압축인가 — 프로덕션에서 이미 일어난 일
현대 코딩 에이전트는 실행 트래젝터리가 자라면서 부분적으로 제거·재작성·요약한다(Anthropic, 2026b; OpenAI, 2026b). 저자가 인용한 프로덕션 규모 증거는 이렇다.
| 지표 | 수치 | 출처 |
|---|---|---|
| GitHub Copilot 세션 트레이스 | 13 million 세션 | Liu et al., 2026 [원문 p.1] |
| 압축이 필요한 세션이 차지하는 토큰 비중 | 전체 서빙 토큰의 44.2% | Liu et al., 2026 [원문 p.1] |
| 중앙값 압축 이벤트가 제거하는 컨텍스트 | 기존 컨텍스트의 72.8% | Liu et al., 2026 [원문 p.1] |
여기서 저자의 핵심 문제의식이 나온다 — 압축은 "토큰을 아끼거나 컨텍스트 창 안에 들어오게 하는 메커니즘"이 아니라, "이후 에이전트 의사결정에 제공되는 정보를 바꾸는" 작업이라는 것이다. 나중에 유용해질 정보를 제거하면 트래젝터리가 달라져 원래 풀었을 과제가 실패로 바뀔 수 있고, LLM을 호출하는 압축 자체가 토큰·지연 오버헤드를 만든다 [원문 p.1].
5. 압축 정책의 설계 공간 — 3축으로 분해하다
기존 시스템(OpenAI, Anthropic, Google, LangChain, OpenHands, Cline 등)은 무엇을 압축할지·언제 압축할지·얼마나 제거할지를 묶어서 고정 정책으로 처리한다. 저자는 이 세 결정을 독립적으로 분리해 체계적으로 특성화해야 한다고 주장하며, 정책을 P/T/D 형식으로 표기한다(예: SU-p/Th/0.5).
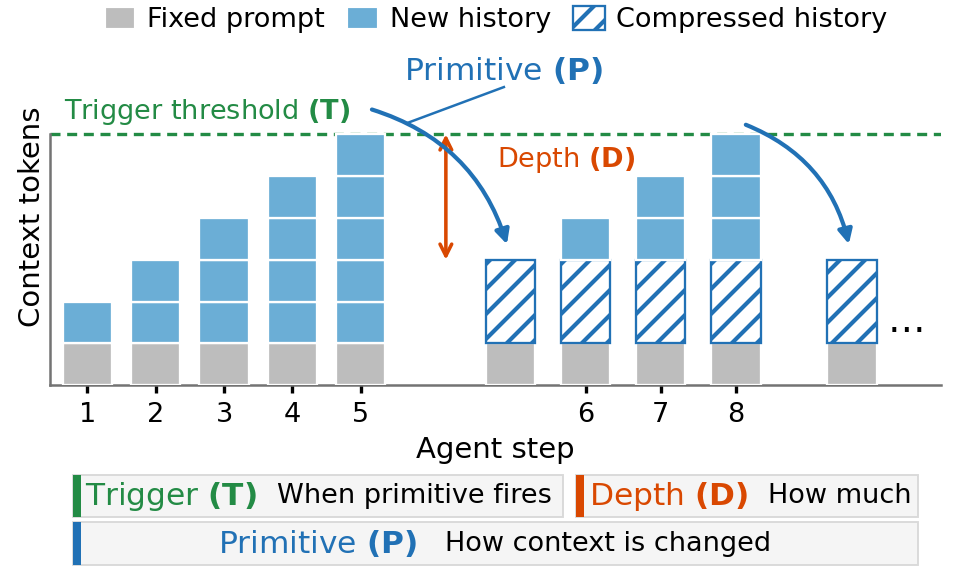
| 축 | 질문 | 설정값 | 성립 조건·예외 |
|---|---|---|---|
| Primitive (P) | 어떻게 압축하는가 | TR, TRC, SU, SS, SU-p, SS-p, 스택형(TRC+SU 등), OTRC | 압축 대상은 compressible window(누적 assistant 메시지 + 도구 결과)에 한정. 시스템 프롬프트·태스크 지시문은 항상 원문 유지 |
| Trigger (T) | 언제 발동하는가 | Threshold(토큰 임계값), Step(매 스텝 후) | 임계값은 압축 미적용 실행의 피크 컨텍스트 분포에서 5/15/25 백분위수로 tight/primary/loose 캘리브레이션. GLM은 primary만 사용 |
| Depth (D) | 얼마나 제거하는가 | D = 1 − target/current, D ∈ {0.3, 0.5, 0.7}, D=0.5 표준 | depth-tunable(TR, SU 계열)에만 깊이 스윕 적용. TRC는 depth-invariant라 스윕 제외 |
프리미티브별 구현 예외까지 확인하면 이렇다 [원문 부록 A.2]:
- TR(Truncation): 가장 오래된 전체 메시지 제거. 마지막 압축 가능 메시지는 유지하되 action–response 쌍은 보존하지 않는다.
- TRC(Tool-result clearing): 오래된 도구 응답을
[output cleared]플레이스홀더로 치환하되 최근 3개 응답은 보존, 부족하면 TR로 폴백. - SU / SS(요약): 압축 이력을 user-role 요약 하나로 치환. SU는 자유 서술(목표·진행·파일·관찰·오류·의결·잔여작업), SS는 5개 고정 섹션(Task, Files Modified, Files Examined, Execution Anchors, Current State).
- SU-p / SS-p(부분 요약): 토큰 할당의 절반은 최근 원문 tail, 절반은 오래된 head 요약. 초과 시 TR 폴백.
- OTRC(스텝 트리거): 토큰 임계값 없이 위치 기반 규칙으로 도구 응답 4개 앞을 클리어(끝에서 9번째 메시지, 최소 5호출·10메시지 조건).
"Different primitives preserve different parts of the trajectory." — 프리미티브 선택이 압축 후 에이전트에게 남는 증거·행동·중간 상태를 결정한다고 저자는 설명한다 [원문 p.3].
6. 실험 설계와 핵심 결과 — 65개 정책, 약 35,000회 실행
실험 구성
| 항목 | 설정 |
|---|---|
| 모델 | Qwen3.5-35B-A3B, Devstral-Small-2-24B, GLM-4.7-Flash (vLLM 로컬 서빙) |
| 벤치마크 | SWE-bench Verified 100 이슈(Django 34, SymPy 34, scikit-learn 32), Terminal-Bench 1.0 40 태스크 |
| 하네스 | 수정된 mini-swe-agent 2.2.6 — 내장 컨텍스트 관리 메커니즘 없음(압축 방해 요소 제거) |
| 조건 | temperature 0.2, 4096 토큰 출력 상한, 구성당 3회 반복 |
| 규모 | 65개 정책 × 3회 반복, 약 35,000회 에이전트 실행 |
| 비용 산정 | Ĉ_input = N_fresh + 0.1·N_cached + N_summary (캐시 입력 1/10 요율, 요약기는 fresh 계상) |
Q1 — 비용-성공 트레이드오프
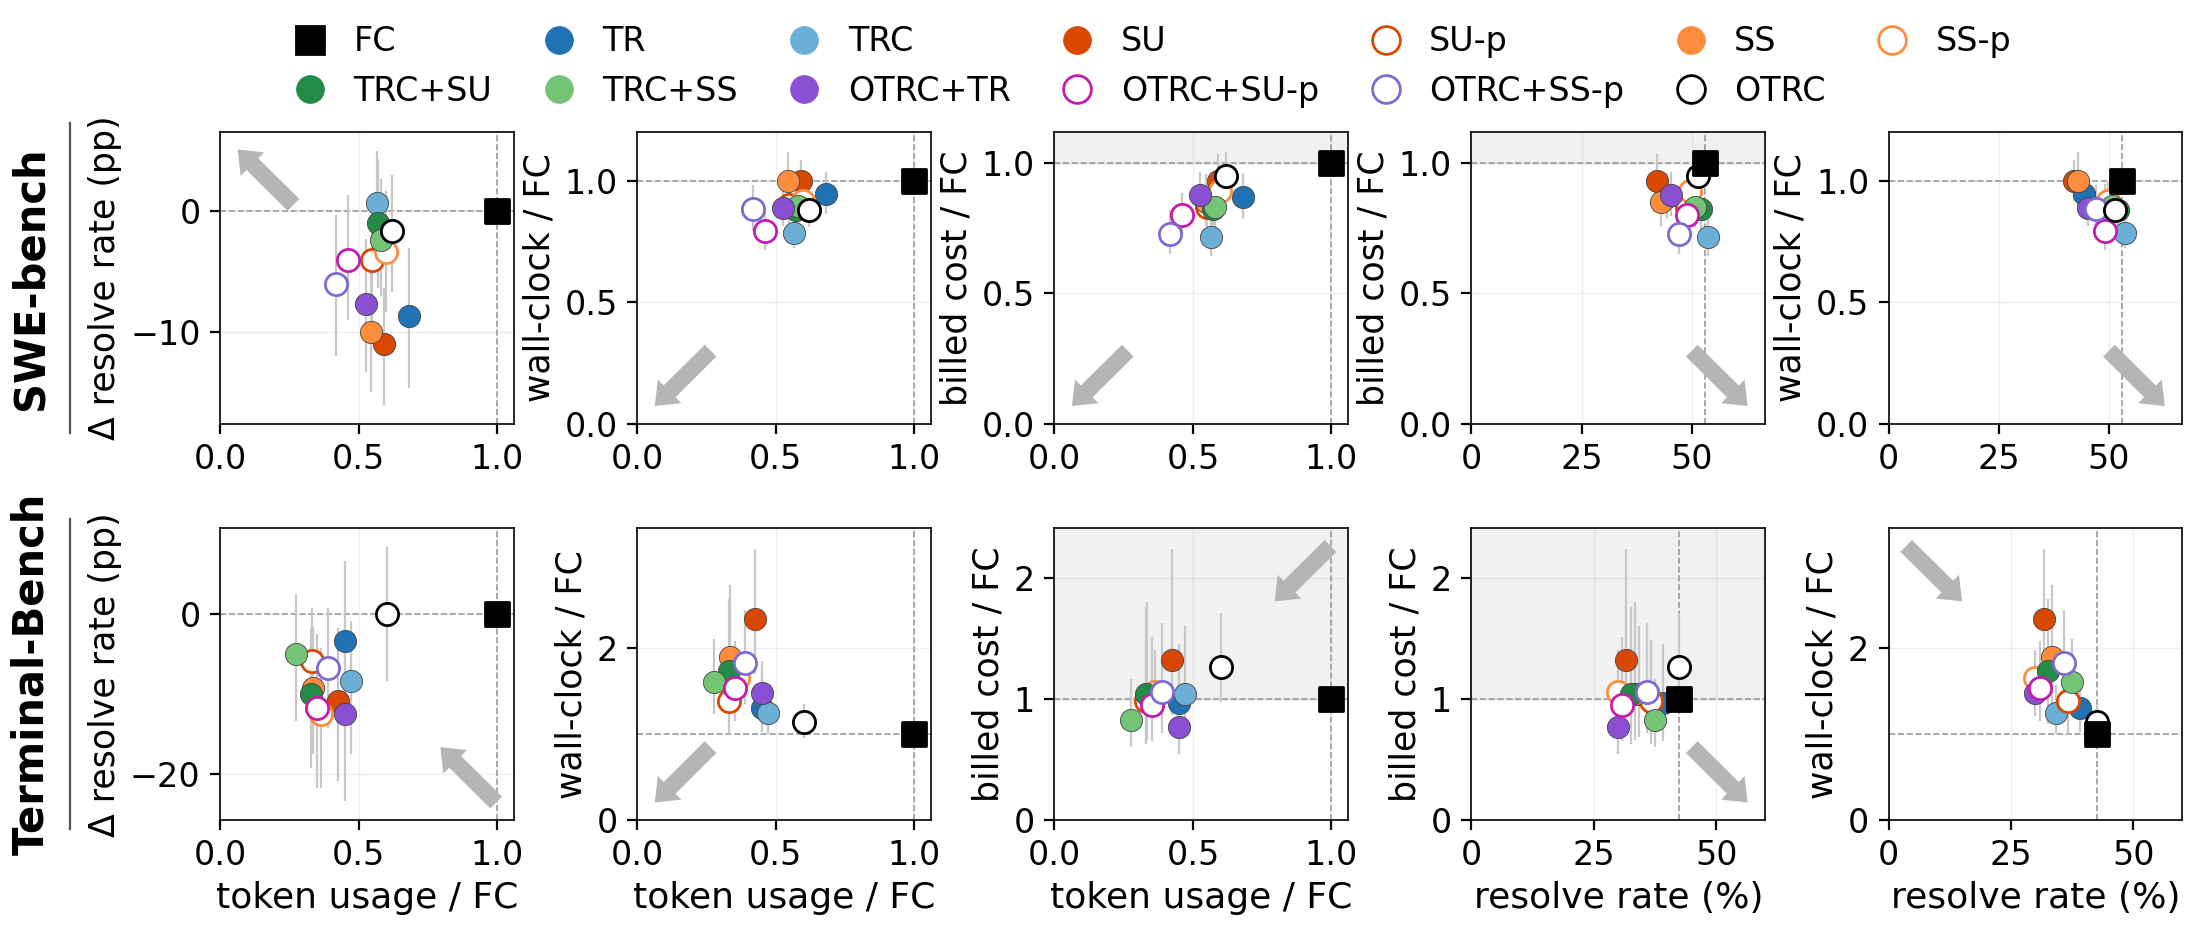
관찰 1: 압축은 토큰 절감을 일관되게 달성한다 — 그러나 성공률·지연·비용에서 트레이드오프가 발생한다.
| 정책 (SWE-bench, Qwen) | 토큰/FC | 성공률 | 비용/FC | 지연/FC |
|---|---|---|---|---|
| TRC | 0.57× | FC 수준 유지 | 0.71× | 0.79× |
| SU | 0.59× | −11.0pp | — | — |
| TRC vs OTRC | 유사 | 53.7% vs 51.3% | 0.71× vs 0.95× | — |
- SWE-bench: 모든 정책이 토큰 0.4–0.7× 사용, 성공률은 FC 대비 −11.0pp ~ +0.7pp
- Terminal-Bench: 토큰 0.25–0.4×로 공격적 절감하나 12개 중 11개 정책이 성공률 5–13pp 하락, 지연 1.05–1.8× 증가
관찰 2: 토큰 절감 ≠ 비용·지연 절감. 스택형 임계값 정책은 토큰 22–55% 절감하면서 호출 수를 유지해 지연 0.88–1.01×를 기록한다 — 스텝 트리거와의 차이다.
관찰 3: 임계값을 늦추는 것이 오히려 이득이 되는 경우가 있다. Qwen SWE-bench 스윕(10K→20K, D=0.5)에서 압축 빈도는 4.85→1.15회/시도로 줄었고, SU의 resolve rate은 50.7%→62.7%, 지연은 653→599초로 개선된다. 저자는 이를 "압축 지연 — 더 많은 히스토리 보존 — 이 반복 개입 감소·성공률·효율을 동시에 개선한" 결과로 해석한다.
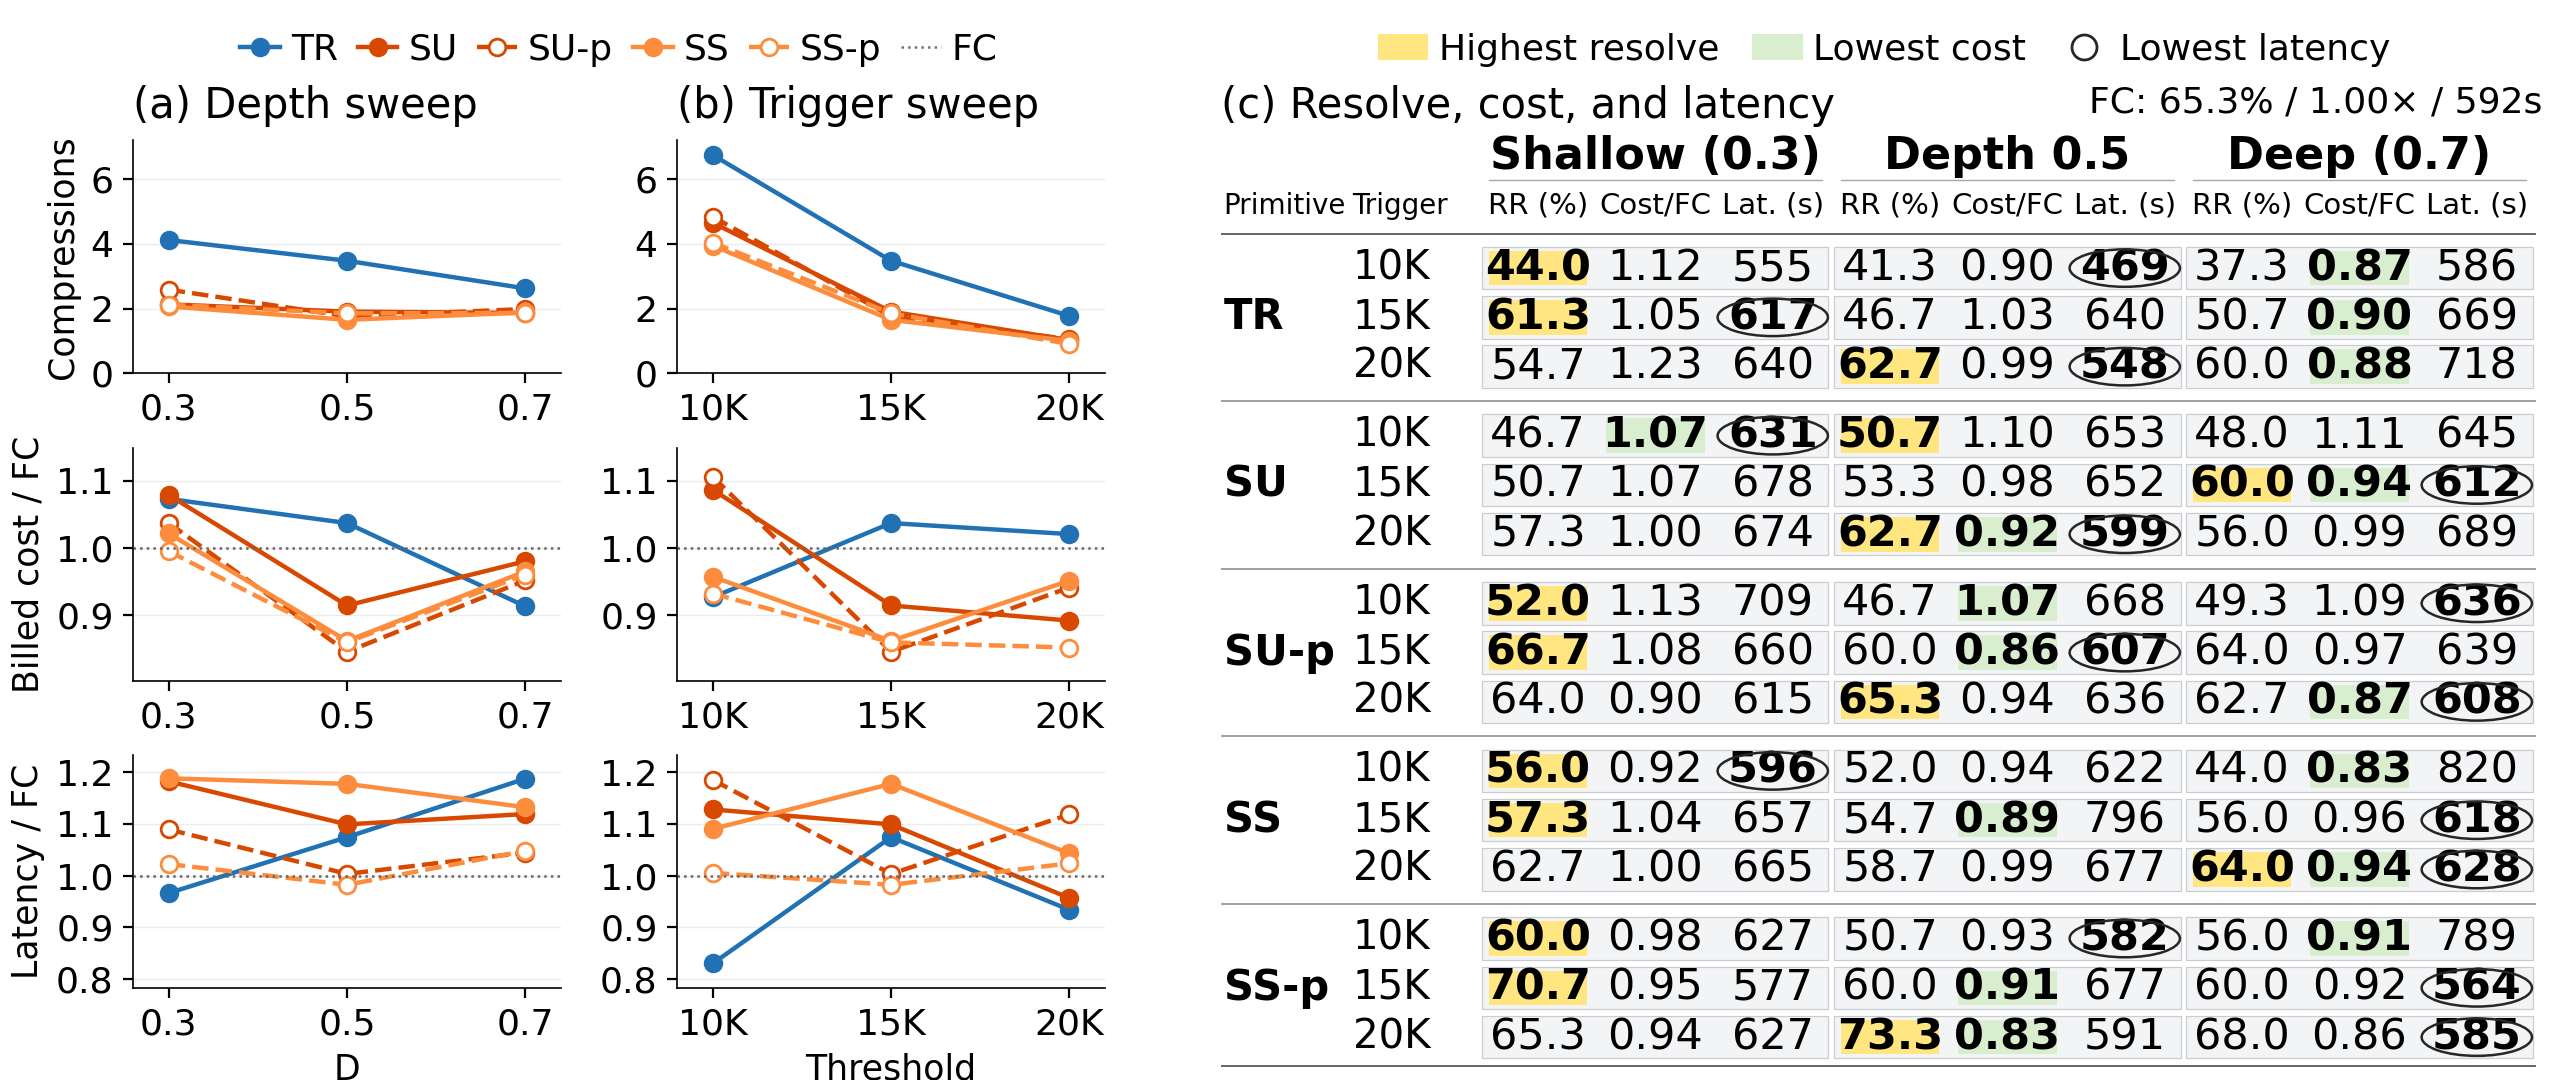
깊이 효과는 프리미티브에 따라 방향이 정반대다 — 이것이 이 연구에서 가장 실무적인 발견 중 하나다.
| 프리미티브 (15K, D 0.3→0.7) | resolve rate | 비용·지연 |
|---|---|---|
| TR (단순 절단) | 61.3% → 50.7% (하락) | 비용·지연 감소 |
| SU (요약) | 50.7% → 62.7% (상승) | 비용·지연 감소 |
시간 제한 시도를 제외해도 방향은 동일하다(TR −15.4%p, SU +7.4%p). 15개 프리미티브-임계값 조합 중 얕은 압축이 최고 resolve rate 8회, 깊은 압축이 최저 비용 8회·최저 지연 7회를 기록했다. 저자는 여기서 Takeaway 1을 도출한다 — 단일 정책이 성공률과 비용 모두에서 지배적이지 않다.
Q2 — 과제 단위로 보면 숨겨진 손실이 보인다
FC가 53과제 해결·47과제 미해결이라는 기준에서, 압축 정책들은 다음과 같이 과제를 바꾼다.
| 정책 | 신규 해결(+lost 없음) | 상실 | 총 해결 (FC 대비) |
|---|---|---|---|
| TRC+SU | +7 | −8 | 52 (−1) |
| SS-p | +7 | −9 | 51 |
| TR | +3 | −14 | 42 |
| Oracle | +17 | −0 | 70 |
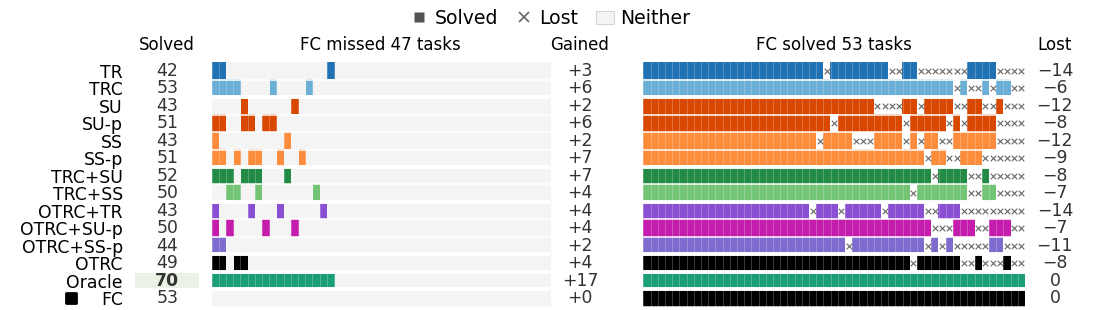
TRC+SU는 총 해결 수에서 FC와 거의 같지만(−1), 실제로는 8개 과제를 잃고 7개를 새로 풀었다. 저자는 Takeaway 2로 "전체 성공률 유사성이 과제 커버리지 보존을 의미하지 않는다"고 정리한다.
Q3 — 모델 간 전이성: 무엇이 통하고 무엇이 안 통하는가
| 검증 항목 | 결과 |
|---|---|
| 모델별 최적 정책 | Qwen TRC 53.7%, Devstral TRC+SS 57.0%, GLM OTRC·SU-p 41.3% — 서로 다름 |
| 순위 역전 | OTRC는 Qwen에서 TR 대비 +7.0pp, Devstral에서 −17.0pp |
| 설정 민감성 | SS-p 임계값 10K→20K에서 Qwen 50.7→73.3% 상승, Devstral은 72–73%로 불변 |
| 일관된 설계 이점 | 최근 이력 보존(SS-p vs SS): Qwen/Devstral/GLM +6.7/+8.7/+8.0pp |
| 일관된 설계 이점 | 요약 전 도구 출력 정리(TRC+SS vs SS): +7.7/+9.7/+9.7pp — 3개 모델 전부 개선 |
| 모델 의존적 효과 | 매 스텝 도구 출력 정리(OTRC vs TRC): −2.3/−14.3/+2.7pp — Devstral에 큰 피해 |
| 워크로드 한계 | OTRC+SS-p vs OTRC는 Terminal-Bench에서 −12.5/−7.5/−12.5pp로 전 모델 악화 |
저자는 Takeaway 3으로 "정책은 모델 간 범용이 아니나 일부 설계 선택은 일관되며, 재사용 가능한 구성요소와 모델·워크로드별 적응의 결합 여지가 있다"고 주장한다.
7. 선행 연구와의 관계 — 무엇을 이어받고 무엇을 새로 열었는가
이 논문의 위치를 균형 있게 보려면 세 갈래를 구분해야 한다.
- 선행 특성화 연구(Packer 2023; Hu 2025; Liu 2024 "Lost in the middle"; Du 2025 등): 긴 트래젝토리가 서빙 난항·성능 저하를 일으킨다는 점을 보였다. 다만 저자에 따르면 이들은 "주어진 컨텍스트 관리 메커니즘 하에서 워크로드를 특성화할 뿐, 압축 정책 자체를 체계적으로 연구하지 않는다" [원문 부록 A.1].
- 압축 기법 제안 연구(Kang et al., 2025; Chen et al., 2026 등): 보존 컨텍스트를 크게 줄이면서 성공률을 유지하는 기법을 제시한다. 저자는 인정하되, "토큰 제거 수만으로 평가하면 중요한 하류 효과를 놓칠 수 있다"며 평가 축을 확장한다.
- 캐시·서빙 인프라(Kwon et al., 2023 PagedAttention; TokenPilot의 prefix-stable compaction 등): 프롬프트 토큰 감소가 청구 비용·지연 감소를 보장하지 않는다는 문제의식을 공유한다. 이 논문은 그 직관을 약 35,000회 실행의 정량 데이터로 뒷받침한다.
후속 연구 방향으로 저자는 실행 관점(성공률·지연·비용·과제 커버리지)의 평가와, 모델·워크로드별 맞춤화를 제시한다. 다만 한계도 명시된다 — Terminal-Bench의 실행 길이 추정치는 2~15개 태스크 기반이라 불확실성을 동반하며, 요약 모델 민감도 실험(SU: self-summarization 53.3% → Qwen3.5-9B 37.3% → Gemma-4-12B 28.0%)은 25태스크 서브셋에서 수행되었다.
관점 포인트 — 실무자가 짚어야 할 5가지
- 압축 평가 지표를 바꿔라 — 토큰 절감률만 보고 도입하면 지연·비용·과제 커버리지 손실을 놓친다.
- TRC부터 벤치마크하라 — 이 실험에서 TRC는 성공률을 유지하면서 토큰 0.57×, 지연 0.79×, 비용 0.71×를 동시에 달성한 가장 균형 잡힌 정책이었다.
- 임계값은 보수적으로 — 10K→20K처럼 압축을 늦추는 쪽이 성공률과 지연을 동시에 개선한 사례가 나왔다(단, 프리미티브·모델에 따라 다름).
- 요약 전 도구 출력을 먼저 정리하라 — TRC+SS vs SS가 3개 모델 모두 +7.7~+9.7pp. 모델을 바꿔도 통한 몇 안 되는 설계 중 하나다.
- 모델을 바꾸면 정책을 재검증하라 — OTRC는 한 모델에서 +7.0pp, 다른 모델에서 −17.0pp의 순위 역전을 보였다.
최종 핵심 정리
확인해야 할 질문 목록:
- 우리 에이전트의 압축 정책은 P(무엇을)·T(언제)·D(얼마나) 중 어디가 하드코딩되어 있는가?
- 토큰 절감을 청구 비용(캐시 1/10 요율 반영)과 지연으로 다시 계산했는가?
- 집계 성공률 말고 과제 단위 gain/loss를 본 적 있는가?
- 새 모델로 옮길 때 압축 정책을 다시 스윕했는가?
- 요약기를 교체했다면 요약 모델 민감도를 확인했는가?
한 줄 요약: 컨텍스트 압축은 토큰 절약이 아니라 에이전트 실행의 재설계다 — 무엇을 아끼는지는 프리미티브가, 언제 아끼는지는 트리거가, 얼마나 아끼는지는 깊이가 결정하고, 그 선택은 모델과 워크로드마다 다시 검증되어야 한다.
댓글 0
아직 댓글이 없습니다 — 첫 댓글을 남겨보세요.