H-JEPA: 하나의 잠재공간을 계층으로 쪼개면 시각적 계획이 달라진다
한 문장 요약: 이 글을 읽으면 JEPA 세계모델을 단일 잠재공간·단일 시간척도에서 수준별 잠재공간의 계층으로 확장하는 H-JEPA의 핵심 아이디어, 성립 조건, 실험 수치를 이해할 수 있습니다.
개요
- 주제: H-JEPA(End-to-End Learning of Hierarchical World Models for Visual Planning) 논문 해설
- 핵심 관점: 저자의 해석·주장은 귀속하여 서술하고, 기술 관계는 성립 조건과 실제 실험 설정까지 확인해 정리
- 핵심 키워드: JEPA, 계층적 세계모델, 시각적 계획, 잠재공간, 시간 분해, SIGReg, IDM
핵심 메시지 3가지
1. 단일 잠재공간의 두 가지 한계 — 저자가 제시한 문제의식
저자는 기존 task-agnostic JEPA 세계모델이 "단일 잠재공간, 흔히 단일 시간척도 안에서 예측하고 계획한다"고 지적하며 두 가지 한계를 든다. 첫째, 단일 시간척도에서는 장기 예측이 세밀한 단계를 많이 굴려야 해 예측 오차가 누적되고 행동 검색 공간이 커진다. 둘째, 하나의 공유 잠재공간이 저수준 동역학과 목표 매칭을 동시에 떠안아, "도달할 위치(목표)처럼 상태보다 추상적인 목표"에는 나쁜 goal-matching 비용이 된다 [원문 §1].
2. 계층이 실제로 만드는 차이 — AntMaze 18% → 73%
초록에 따르면, 네 개의 시뮬레이션 내비게이션·조작 환경에서 계층 계획은 flat JEPA를 앞서며, Visual AntMaze에서 세 수준 계층은 성공률을 18%에서 73%로 끌어올리면서 planner compute는 더 적게 사용했다 [원문 Abstract]. 저자는 이 이득이 시간 분해와 상위 수준 목표 표현 두 기제에서 함께 나온다고 주장한다.
3. 계층의 이득은 "환경 조건부" — 모든 환경에서 나오지 않는다
저자는 선택적 추상화(selective abstraction)가 모든 환경에서 나타나지 않으며, 훈련 데이터의 시간 주파수 격차(entity frequency gap)가 1천분의 5 미만인 환경에서는 거의 나타나지 않는다고 보고한다. Push-T에서는 3수준 모델이 최대 compute에서도 poorly 수행한다 — 저자는 그 원인을 짧은 에피소드로 인한 학습 데이터 부족(3수준이 LeWM 대비 에포크당 전이의 58%만 사용, 4수준은 14%)으로 해석한다 [원문 §4.1].
1. 왜 이 주제를 알아야 하는가
세계모델은 환경 경험으로부터 동역학을 학습해 에이전트가 예측·이해·계획을 가능하게 한다. JEPA는 픽셀 대신 미래 잠재 상태를 예측해 보상·픽셀 재구성 모두를 피하고, 최근의 행동조건부·task-agnostic JEPA 세계모델은 학습된 잠재공간에서 zero-shot 계획을 수행한다 [원문 §1]. 그런데 그 계획이 대부분 하나의 잠재공간, 하나의 시간척도에 갇혀 있다는 것이 이 논문의 출발점이다.
2. H-JEPA란 무엇인가
쉽게 말하면 각 수준이 자기만의 잠재공간에서 더 먼 미래를 예측하는, 행동조건부 JEPA의 계층 학습 레시피입니다.
핵심 특징
- 수준별 독립 잠재공간: 각 수준이 자기 잠재공간 안에서 예측, 보상·픽셀 재구성 목표 없음
- 시간적 계층: level 1이 가장 세밀한 관측 스트림을 다루고, 상위 수준은 아래 수준의 잠재 상태를 더 굵은 stride로 소비
- Top-down 계획: 최상위가 목표를 향해 거친 계획을 세우고, 각 수준의 예측이 아래 수준 플래너의 subgoal이 됨
3. 어떻게 작동하는가 — 성립 조건과 실제 설정
학습 구조 (§2.1)
각 수준 ℓ > 1에는 두 시간 하이퍼파라미터가 있다: stride s_ℓ(부sampling 계수)과 window size w_ℓ(각 상위 상태가 요약하는 하위 단계 수). 둘은 독립이다 — s_ℓ가 창이 얼마나 전진하는지, w_ℓ가 얼마나 넓은지를 정한다 [원문 §2.1].
- 성립 조건(일반형): 상태 인코더 E^(ℓ)는 w_ℓ-스텝 창을 하나의 추상 상태로 풀링하고, 행동 인코더 A^(ℓ)는 w_ℓ와 무관하게 s_ℓ개 하위 행동 잠재를 집계해, z_t^(ℓ)를 다음 상위 상태로 향하는 전체 전이를 커버한다.
- 저자가 실제 사용한 설정(예외): 모든 실험에서 w_ℓ = 1 — 따라서 상위 수준 상태 인코더는 pointwise(逐点)로 동작한다 [원문 §2.1].
- 수준별 목표함수: L^(ℓ) = L_pred^(ℓ) + λ_ℓ·SIGReg(Z^(ℓ)) — teacher-forced 잠재 예측 손실에 붕괴 방지 정규화자 SIGReg[6]를 결합. 환경 내 모든 수준이 동일한 SIGReg 계수를 공유한다 [원문 §3 Setup].
계층 계획 (§2.2)
① 현재·목표 관측을 모든 수준에서 인코딩 → ② 최상위가 최종 예측과 목표의 거리를 최소화하도록 macro-action 최적화 → ③ 상위의 최적화된 예측轨迹가 하위의 subgoal이 됨 → ④ 하위 수준은 상위 인코더 E^(ℓ+1)로 자기 예측을 투영해 subgoal과 정렬 → ⑤ level 1에서 원시 행동 출력
결합 조건(중요): 하위 수준 지평은 H_ℓ = K_{ℓ+1}·s_{ℓ+1} + w_{ℓ+1} − 1 로 설정해야 subgoal이 시간·잠재공간 양쪽에서 정렬된다. Closed-loop 계획은 K_{ℓ+1} = 1(첫 예측 subgoal만 매칭), open-loop는 K_{ℓ+1} = H_{ℓ+1}에 β = 0(종착 예측만) 또는 β > 0(중간 subgoal 포함) [원문 §2.2].
실험에 실제 사용된 설정
| 항목 | 저자의 실제 설정 | 출처 |
|---|---|---|
| 최대 수준 수 | 최대 4수준 end-to-end 학습 | 01_2610.06805v1.pdf (§3 Setup) |
| Level 1 | LeWM[53]: ViT-Tiny 인코더([CLS] 토큰) + causal transformer 예측기 | 01_2610.06805v1.pdf (§3 Setup) |
| 상위 수준 인코더 | 2-layer MLP 인코더 + causal transformer 예측기 | 01_2610.06805v1.pdf (§3 Setup) |
| stride / window | s_ℓ = 2, w_ℓ = 1 (상위 1단계 예측 = 하위 1천분의 5 환경 스텝) | 01_2610.06805v1.pdf (§3 Setup) |
| 정규화 | 환경 내 전 수준 동일 SIGReg 계수 | 01_2610.06805v1.pdf (§3 Setup) |
| 평가 | 2-layer MLP 프로브, variance-normalized MSE(NMSE), 3개 학습 seed의 mean ± SE | 01_2610.06805v1.pdf (§3 Evaluation) |
4. 계층이 만드는 첫 번째 이득: 더 추상적인 비용 공간
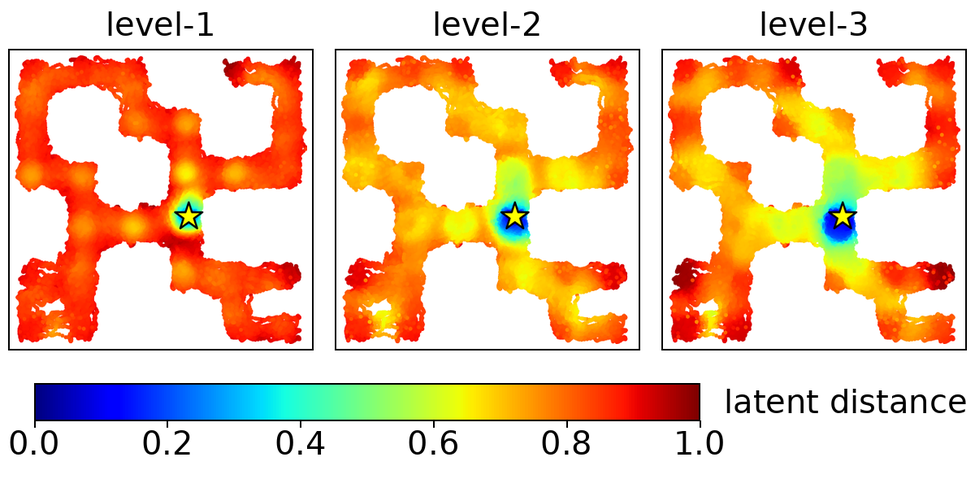
저자는 계획 비용 기하(cost geometry)를 시각화하며, level-1 거리는 anchor에서 멀어지면 거의 일정해 gradient 플래너에 신호를 거의 주지 않는 반면, 상위 수준에서는 복도를 따라 매끄럽게 비용이 상승한다고 보고한다 [원문 §4.2, Fig. 7].
"비용만 바꾸는" 제어 실험(Table 1, AntMaze 성공률 %, mean ± SE, 3 seeds) — 각 열은 동일한 level-1 세계모델·플래너 설정을 공유하고 목표 비용을 쓰는 잠재공간만 변경:
| Cost / planner | 2 levels↑ | 3 levels↑ | 4 levels↑ |
|---|---|---|---|
| Native L1 | 23.3 ± 3.3 | 16.7 ± 1.8 | 10.0 ± 0.0 |
| L2 projection | 31.3 ± 2.7 | 20.7 ± 4.8 | 20.7 ± 1.8 |
| L3 projection | – | 22.0 ± 2.3 | 21.3 ± 4.7 |
| L4 projection | – | – | 26.7 ± 2.9 |
| Hierarchical (전체 계층 계획) | 39.3 ± 3.7 | 73.3 ± 3.5 | 63.3 ± 7.7 |
(출처: 01_2610.06805v1.pdf Table 1)
- 계산 예시: 3수준 모델에서 Native L1 비용 16.7% → 전체 계층 계획 73.3%, 차이 = 73.3 − 16.7 = 56.6%p.
- 저자는 "테스트한 모든 다수준 H-JEPA에서 최소 하나의 상위 수준 비용이 native level-1 비용보다 성공률을 높인다"고 주장하며, AntMaze의 최적 투영 플래너는 모든 깊이에서 별도 학습된 LeWM 기준선(18.0 ± 3.5%)의 평균 성공률을 상회한다고 서술한다 [원문 §4.2].
5. 계층이 만드는 두 번째 이득: 시간 분해
저자는 flat 플래너의 전체 지평 목표 비용이 전문가轨迹에서도 정체·상승해 진행 측정이 불일치할 수 있다고 지적하며(Fig. 8), subgoal 추적 비용이 훨씬 단조롭게 감소함을 보인다:
- 단조성(비용-시간의 음의 Spearman 상관): H-JEPA의 subgoal 추적은 0.89–1.00, 전체 지평 목표 비용은 0.48–0.75 (4개 시뮬레이션 환경 전체, Table 10) [원문 §4.2].
- 저자는 HWM[92]도 이 개선을 보이므로, 시간 분해가 HWM의 LeWM 대비 이득에 기여한다고 해석한다.
6. 선행 연구와의 관계 — 균형 잡힌 위치 비교
| 연구 계열 | 기여 | 논문이 지적하는 한계 | 출처 |
|---|---|---|---|
| JEPA 계보 [49, 1, 9] | 픽셀 대신 잠재 예측, 보상·재구성 회피 | 단일 잠재공간·단일 시간척도 | 01_2610.06805v1.pdf Page1 (§1) |
| 계층 영상 모델 [68, 44, 55] | 다중 시간척도 표현 학습 | 픽셀 재구성, 제어에 사용되지 않음 | 01_2610.06805v1.pdf Page1 (§1) |
| 계층 model-based RL [32, 36, 27] | 보상 기반 계층 제어 | task-specific, 보상 의존 | 01_2610.06805v1.pdf Page1 (§1) |
| HWM [92] (가장 유사) | 무보상 오프라인 데이터로 다중 지평 세계모델 학습·계층 계획 | 하나의 잠재공간 공유 — 지평은 분해하되 더 추상적인 공간에서 목표를 매칭하지 못함 | 01_2610.06805v1.pdf Page1 (§1), §5 |
| LeWM [53] | end-to-end 학습 단일 수준 플래너 | H-JEPA의 level 1이자 flat 기준선으로 채택됨 | 01_2610.06805v1.pdf (§3) |
저자는 HWM과의 비교에서 "HWM은 모든 네 환경에서 LeWM보다 높은 평균 성공률을 달성해, 표현 계층 없이도 시간 분해의 이점을 뒷받침한다"고 평가한 뒤, H-JEPA의 추가 이득 — 특히 AntMaze에서 3수준 H-JEPA가 HWM의 약 1천분의 5 성공률 — 을 시간 분해를 넘어서는 계층 표현의 이점으로 해석한다 [원문 §4.1]. 즉 논문은 선행 연구의 기여(시간 분해)를 인정하면서, 자기 기여(수준별 잠재공간)를 분리해 주장한다.
7. DROID 확장: IDM 손실이라는 결합 조건
장면이 에피소드마다 변하면 배경이 로봇보다 더 예측 가능해져, 순수 예측 목표는 에이전트를 버리고 장면을 인코딩하는 slow-feature 해를 취하게 된다. 저자는 이를 피하기 위해 역동학 모델(IDM) 손실을 목표에 추가한다 [원문 §4.3].
- 성립 조건: 정규화자가 임베딩의 주변(marginal) 분포만 볼 때 이 해는 항상 존재하며, 시간에 걸친 표현의 결합 분포에 작용하는 손실이 필요하다.
- 실측 수치: IDM 없이는 모델이 붕괴해 성공률 0. DROID의 잠재 분산은 에피소드 간 75%, OGBench Cube는 28% — 장면 다양성이 클수록 붕괴 위험이 크다 [원문 §4.3].
- 평가 지표: 시뮬레이터가 없는 DROID에서는 3D end-effector 경로의 Fréchet fidelity(0% = 팔 미동, 100% = 전문가 경로, 음수 = 무동작보다 나쁨)로 오프라인 점수화.
- 저자는 DROID에서도 "H-JEPA가 HWM에 명확한 우위를 보이며 §4.2의 표현·시간 두 레버가 모두 작동한다"고 주장하며, flat 모델보다 낮은 planner budget에서 더 높은 성능에 도달했다고 서술한다 [원문 §4.3].
관점 포인트
- w_ℓ = 1이 기본 설정이다 — 일반형 수식의 window 풀링이 실험에서는 pointwise 인코더로 축소된다. 일반화 시 이 예외를 잃으면 안 된다.
- stride s_ℓ = 2가 기본이다 — 상위 1스텝 = 하위 2스텝. Fig. 8의 시간 분해 분석만 s₂ = 3의 2수준 모델로 수행된 별도 설정이다.
- Closed-loop은 K = 1이 기본 — 첫 subgoal만 매칭하고 반복. open-loop(K = H)는 β 설정에 따라 종착만 vs 중간 포함으로 갈린다.
- 비용 실험의 통제 변수는 "level-1 세계모델과 플래너 설정을 고정하고 잠재공간만 변경"하는 것 — 이 통제가 없으면 비용 기하 기여를 분리할 수 없다.
- Push-T의 3수준 실패는 구조 실패가 아니라 데이터량 문제로 저자는 해석한다(에포크당 전이 58%). 계층 깊이 실험에서는 클립이 하나의 에피소드 안에 있어야 한다는 데이터 제약을 함께 봐야 한다.
- 주파수 격차 1천분의 5 미만이면 선택적 추상화 없음 — 계층 이득을 기대할 수 있는 환경 조건이 정량적으로 명시돼 있다.
최종 핵심 정리
이 글을 읽고 확인해야 할 질문:
- Q. 각 수준은 무엇이 다른가? → 잠재공간·stride·추상화 수준이 다르고, 예측 목표는 동일한 잠재 예측 + SIGReg이다.
- Q. 계층 계획의 성립 조건은? → H_ℓ = K_{ℓ+1}s_{ℓ+1} + w_{ℓ+1} − 1 로 하위 지평이 상위 인코더 창과 정렬되어야 한다.
- Q. 저자가 실제 쓴 설정은? → 최대 4수준, s_ℓ = 2, w_ℓ = 1, level 1 = LeWM, closed-loop K = 1.
- Q. 이득의 원인은? → 저자는 추상적 비용 공간(표현)과 시간 분해(지평)의 두 기제로 분리해 귀속한다.
- Q. 언제 이득이 사라지나? → 주파수 격차 < 1천분의 5 환경, 데이터 부족 환경(Push-T), IDM 없는 비정상적 장면(DROID).
한 줄 요약: H-JEPA는 "지평 분해만으로는 부족하다"는 HWM과의 대비에서 출발해, 수준별 잠재공간이라는 표현 계층과 시간 분해라는 계획 계층을 end-to-end로 결합할 때, 특히 AntMaze에서 18% → 73%의 성공률 향상을 얻을 수 있음을 보여주는 논문이다.
댓글 0
아직 댓글이 없습니다 — 첫 댓글을 남겨보세요.